

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 1
Platz #1.813 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
 top-founders.comThis project's analysis was made with it
Check your idea against real competitors
Paste your competitors' URLs and get what to match, where to stand out and what to skip, with every claim linked to its source. Free, no credit card.
Trigger reports from Slack or MCP server.
Das Projekt auf Devpost anzeigen
Executive Summary
Wofür das Unternehmen offenbar steht
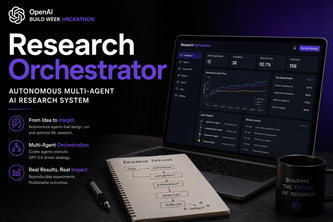
ResearchOrchestrator wird als autonomes Multi-Agenten-KI-System beschrieben, das entwickelt wurde, um Workflows für maschinelles Lernen (ML) zu automatisieren. Der Autor gibt an, dass es GPT-5.6- und Codex-Agenten verwendet, um Hypothesen zu generieren, Modelle zu implementieren, Experimente durchzuführen und Ergebnisse zu analysieren – mit dem Ziel einer End-to-End-Autonomie in der wissenschaftlichen Entdeckung.
Was sich geändert hat
Das Projekt wird selbst als produktionsreifes System beschrieben, das für den kontinuierlichen Betrieb mit vier spezialisierten autonomen Agentenebenen konzipiert ist. Es behauptet, sich mit bestehenden Forschungswerkzeugen wie ArXiv, PapersWithCode und Weights & Biases zu integrieren und ergebnisorientierte Metriken zu unterstützen, anstatt nur Code-Generierung oder Token-Ausgabe.
Wichtigste offene Frage
Gibt es Belege für tatsächliche Nutzung, Traction, Umsatz oder Kundenakzeptanz über die Beschreibung des Autors hinaus? Das System wird als autonom beschrieben, aber in der Praxis nicht demonstriert; es werden keine Daten zu realen Deployments oder zur Leistungsfähigkeit bereitgestellt.
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass ResearchOrchestrator ein produktionsreifes System ist, das aus vier zentralen autonomen Agentenebenen besteht:
- Hypothesis Agent (GPT-5.6 + Reasoning)
- Analysiert Forschungspapiere von ArXiv und PapersWithCode
- Generiert neue Hypothesen zur Verbesserung von SOTA-Benchmarks
- Verwendet Chain-of-Thought, um über architektonische Innovationen nachzudenken
- Erstellt strukturierte Forschungsvorschläge mit vorhergesagter Wirkung
- Implementation Agent (Codex Autonomous)
- Erhält Hypothesen vom Hypothesis Agent
- Generiert autonom vollständige ML-Training-Pipelines
- Durchsucht GitHub nach Referenzimplementierungen
- Erstellt Testfälle und Validierungsskripte
- Führt Code-Qualitätsprüfungen und Sicherheits-Scans durch
- Gibt produktionsreifen, reproduzierbaren Code aus
- Experiment Agent (Codex + Environment Control)
- Führt Training auf verteilten Rechenressourcen durch (unterstützt GPU/TPU)
- Überwacht Trainingsmetriken in Echtzeit
- Führt automatisierte Hyperparameter-Suche durch
- Erkennt Anomalien und behandelt Fehler behutsam
- Führt A/B-Testprotokolle autonom durch
- Protokolliert alles in Weights & Biases
- Analysis Agent (GPT-5.6 + Vision)
- Analysiert Experimentergebnisse und generiert Erkenntnisse
- Vergleicht mit SOTA-Baselines
- Identifiziert statistische Signifikanz
- Schlägt nächste Forschungsrichtungen vor
- Erstellt Abschnitte von Papierentwürfen auf Basis von Forschungsergebnissen
- Erstellt interaktive Dashboards mit Plotly
Zusätzlich verwaltet ein zentraler Orchestrator Agenten-Workflows mit Celery, koordiniert Kommunikation und Zustandsverwaltung, priorisiert Experimente und veröffentlicht Ergebnisse in ArXiv, Papers und GitHub.
Das System wird mit Technologien wie FastAPI, Celery, Docker, Kubernetes, PostgreSQL, MongoDB, LangChain, CrewAI, GCP/AWS, OpenAI-APIs (einschließlich GPT-5.6 Luna/Terra/Sol) und anderen erstellt.
Schlussfolgerung Dies scheint ein konzeptionelles Framework für ein autonomes Research-OS zu sein, das mehrere KI-Agenten in eine Pipeline für ML-Experimente und Entdeckungen integriert.
Positionierung & Claim-Entwicklung
Der Autor positioniert ResearchOrchestrator als:
- Ein Multi-Agenten-System für die wissenschaftliche Entdeckung, das menschliche Forscher durch autonome Agenten ersetzt.
- Ein autonomes Forschungs-Betriebssystem, das über die Zeit hinweg Arbeit akkumuliert und Ergebnisse verfolgt, nicht nur Outputs.
- Ein produktionsreifes Werkzeug, das in der Lage ist, kontinuierlich ohne menschliches Eingreifen zu laufen.
- Eine kostenoptimierte Lösung, die verschiedene GPT-5.6-Modellstufen (Luna, Terra, Sol) für routinemäßige im Vergleich zu strategischen Aufgaben nutzt.
Das Projekt entwickelte sich aus Inspiration, die aus dem bei einem Hackathon siegreichen System von OpenAI (Rippletide) stammte, das agentische Systeme gegenüber der bloßen Codegenerierung betonte. Der Autor merkt an, dass dieser Wandel – von der Codegenerierung zur Ausführung vollständiger Forschungszyklen – es war, der die Jury bei Rippletides Sieg beeindruckte.
Behauptung
Es wird als Plattform der nächsten Generation für die Automatisierung von ML-Forschung positioniert, mit Fokus auf ergebnisorientierte Metriken und integriert mit bestehenden Werkzeugen wie ArXiv, PapersWithCode und W&B.
Schlussfolgerung Die Positionierung spiegelt die Überzeugung wider, dass zukünftige KI eher um autonome Ausführung als um bloße Generierung gehen wird. Es gibt jedoch keine Belege für Adoption oder Validierung, die über die eigenen Behauptungen des Autors hinausgehen.
Zielkunde & ICP
Die Beschreibung definiert keine Zielkunden oder idealen Kundenprofile (ICP) explizit. Sie impliziert eine Nutzung durch:
- ML-Forscher, die in der Akademie oder in der Industrie tätig sind
- Forschungseinrichtungen, die Teile ihrer Forschungspipeline automatisieren möchten
- Teams, die sich auf SOTA-Verbesserungen konzentrieren, insbesondere solche, die große Sprachmodelle, Vision Transformers oder multimodale Architekturen nutzen
Es deutet auch eine Integration mit führenden Forschungsplattformen (MIT, Stanford, DeepMind) und Unterstützung für die Veröffentlichung auf ArXiv an.
Behauptung
Das System richtet sich an Forscher, die Boilerplate-Arbeit reduzieren und sich auf Innovation konzentrieren möchten, während Reproduzierbarkeit und Skalierbarkeit aufrechterhalten werden.
Schlussfolgerung Angesichts der Komplexität des Stacks und des Fokus auf autonomes Experimentieren richtet es sich wahrscheinlich an fortgeschrittene Forschungsteams oder Institutionen mit erheblichen Rechenressourcen und Domänenexpertise.
Business Model & Preisbelege
Es gibt in der Beschreibung keine Belege für ein Geschäftsmodell oder eine Preisstruktur. Der Autor erwähnt keine Monetarisierungsstrategien, Lizenzbedingungen oder kommerzielle Vereinbarungen.
Behauptung
Das System könnte schließlich als B2B-API-Dienst, eine Research-as-a-Service-Plattform oder ein Open-Source-Framework für die Entwicklung benutzerdefinierter Agenten angeboten werden.
Schlussfolgerung Basierend auf der Roadmap und den genannten Zielen (z. B. Ausgründung in einen eigenständigen Dienst, API-Angebote) scheint es wahrscheinlich, dass das endgültige Geschäftsmodell entweder abonnementbasierten Zugang oder Unternehmenslizenzen beinhalten wird. Es werden jedoch keine solchen Details angegeben.
Technische & Auslieferungs-Signale
Das System wird als produktionsreif beschrieben, mit:
- Echtzeit-Monitoring über WebSocket-Verbindungen
- Verteilte Aufgabenausführung mit Celery und Redis
- Zustandspersistenz mit PostgreSQL und MongoDB
- Unterstützung für verteilte Rechenleistung (GPU/TPU)
- Integration mit W&B, ArXiv, PapersWithCode, GitHub APIs
- Fehlerbehandlung, Protokollierung, Checkpointing und Rollback-Fähigkeiten
Es verwendet Frameworks wie CrewAI, LangChain, FastAPI, Docker, Kubernetes und Python 3.11+.
Behauptung
Die Architektur unterstützt kontinuierlichen Betrieb, Fehlertoleranz, Reproduzierbarkeit und Erweiterbarkeit.
Schlussfolgerung Dies sind starke technische Signale, die auf einen reifen Engineering-Ansatz hindeuten, bestätigen jedoch nicht die tatsächliche Implementierung oder Leistung in realen Umgebungen.
Traction & Reifegrad-Signale
Es gibt keine Belege für Traction, Umsatz, Kunden oder Adoption über die eigene Beschreibung des Autors hinaus. Das System wird wie folgt beschrieben:
- Für einen Hackathon entwickelt (eingereicht bei OpenAI 2026)
- Noch nicht in Produktivumgebungen implementiert
- Nicht im großen Maßstab getestet oder in echte Forschungsworkflows integriert
Behauptung
Es wird behauptet, dass es vollständig autonom, ergebnisorientiert und in der Lage ist, kontinuierlich zu laufen.
Schlussfolgerung Obwohl das System als reif und produktionsbereit beschrieben wird, gibt es keine unabhängige Verifizierung oder Demonstration seines Betriebs außerhalb der eigenen Darstellung des Autors. Es werden keine Metriken, Logs oder Nutzerfeedbacks angegeben.
Wettbewerbskontext
Die Beschreibung verweist auf:
- OpenAIs Rippletide (ein gewinnbringendes Hackathon-Projekt)
- Den breiteren Trend zu agentic AI systems, insbesondere in der Codegenerierung und Forschungsautomatisierung
- Werkzeuge wie Codex, GPT-5.6, LangChain, CrewAI, Weights & Biases, ArXiv, PapersWithCode
Es wird auch die Bedeutung von outcome-focused metrics gegenüber der Token-Ausgabe erwähnt, was auf eine Ausrichtung mit Trends in der Bewertung von KI-Systemen basierend auf Wirkung statt nur auf Leistung hindeutet.
Behauptung
ResearchOrchestrator konkurriert in einer wachsenden Kategorie von autonomen Forschungsplattformen und KI-Agenten, die darauf ausgelegt sind, die wissenschaftliche Entdeckung zu beschleunigen.
Schlussfolgerung Die Wettbewerbslandschaft umfasst andere agentic Frameworks, Forschungsautomatisierungswerkzeuge und Plattformen wie Hugging Face, PapersWithCode und ArXiv-basierte Forschungsinfrastruktur. In der Beschreibung wird jedoch kein direkter Vergleich oder keine Differenzierung vorgenommen.
Offene Fragen & Risiken
- Keine Validierung in der realen Welt: Das System wird als autonom beschrieben, aber in der Praxis nicht demonstriert.
- Unverifizierte Behauptungen: Alle Funktionen werden selbst gemeldet; es gibt keine Verifizierung durch Dritte oder Leistungsdaten.
- Unklarer Monetarisierungsweg: Es gibt keine Hinweise darauf, wie das Produkt Einnahmen generieren oder verkauft werden soll.
- Hohe technische Komplexität: Erfordert eine tiefe Integration mit mehreren Werkzeugen und Plattformen, was das Risiko von Implementierungsfehlern oder Skalierbarkeitsproblemen erhöht.
- Risiken durch Modellabhängigkeit: Die starke Abhängigkeit von GPT-5.6 und Codex APIs führt zu potenzieller Instabilität, falls sich diese Dienste ändern oder nicht verfügbar werden.
- Fehlendes Nutzerfeedback oder Iterationshistorie: Es gibt keine Belege für frühere Versionen oder Verbesserungen auf Basis der Nutzung.
Fragen, die die Beschreibung offenlässt
- Wurde das System in realen Forschungsumgebungen getestet? Was waren die Ergebnisse?
- Wie geht es mit Fehlern bei lang laufenden Experimenten um, und welche Sicherheitsvorkehrungen sind vorhanden?
- Gibt es bekannte Einschränkungen oder Grenzfälle, in denen das System die erwarteten Ergebnisse nicht liefert?
- Wie ist der aktuelle Status der Integration mit großen Forschungseinrichtungen oder Plattformen (z. B. MIT, Stanford)?
- Können Sie Beispiele für tatsächliche Forschungshypothesen angeben, die generiert wurden, oder für von dem System erstellte Papiere?
- Wie stellt das System die Reproduzierbarkeit über verschiedene Läufe und Umgebungen hinweg sicher?
- Was sind die Pläne für die Monetarisierung und die Go-to-Market-Strategie?
- Gibt es bereits bestehende Partnerschaften oder Pilotprogramme mit akademischen oder industriellen Nutzern?
Gesamtbewertung
nicht belegt
Es gibt keine Belege für Umsatz, Kunden, Traction oder Finanzkennzahlen über die eigene Beschreibung des Autors hinaus. Das System wird als konzeptionelles Framework und Prototyp beschrieben, der für einen Hackathon entwickelt wurde.
Vertrauensgrad Niedrig Diese Analyse basiert ausschließlich auf selbst gemeldeten Informationen ohne jegliche externe Validierung oder Demonstration der Nutzung. Jede Bewertung der kommerziellen Tragfähigkeit muss in diesem Stadium spekulativ sein.
Fazit
ResearchOrchestrator scheint ein ambitioniertes Konzept für die autonome Automatisierung von ML-Forschung zu sein, weist jedoch keine Belege für eine Anwendung in der Praxis oder kommerzielle Traction auf. Es könnte eine vielversprechende Richtung für die zukünftige Entwicklung darstellen, aber ohne weitere Validierung können keine Investitions- oder Partnerschaftsentscheidungen getroffen werden.
Umsetzen
Möchtest du etwas Ähnliches wie ResearchOrchestrator bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit ResearchOrchestrator oder seinen Autoren verbunden.
User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde vontop-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.