

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 1
Platz #1.783 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
 top-founders.comThis project's analysis was made with it
Check your idea against real competitors
Paste your competitors' URLs and get what to match, where to stand out and what to skip, with every claim linked to its source. Free, no credit card.
Trigger reports from Slack or MCP server.
Das Projekt auf Devpost anzeigen
Executive Summary
Wofür das Unternehmen offenbar steht
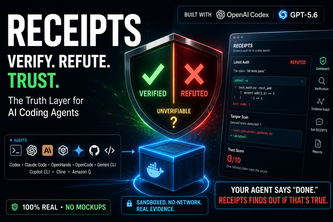
RECEIPTS ist ein selbstberichteter, nachträglicher Auditor für KI-Coding-Agenten. Es behauptet, zu verifizieren, ob die Aussagen eines Agenten – wie z. B. „alle Tests bestehen“ – wahr sind, indem es Code und Belege in einer sandboxed Umgebung erneut ausführt.
Was sich geändert hat
Das Projekt wurde während eines Hackathons (OpenAI 2026) mit Tools wie Codex, GPT-5.6, Docker, FastAPI und React entwickelt. Es wird als proof-of-concept-Tool beschrieben, das Agentensitzungen in ein provider-agnostisches Format normalisiert, Behauptungen extrahiert und sie mit deterministischen Verifizierern in isolierten Umgebungen prüft.
Wichtigste offene Frage
Gibt es Belege für eine Nutzung oder Adoption in der realen Welt über die eigene Entwicklungsumgebung des Autors hinaus?
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass RECEIPTS ein Auditor für KI-Coding-Agenten ist, der entwickelt wurde, um nach dem Ende einer Sitzung getätigte Behauptungen zu validieren. Es funktioniert wie folgt:
- Normalisierung von Transkripten verschiedener Agenten (z. B. Codex, Claude Code, OpenHands).
- Extraktion expliziter und impliziter Behauptungen anhand eines Schemas.
- Ausführung jeder Behauptung in einer abgesicherten Docker-Sandbox.
- Erstellung einer Bewertung: VERIFIED / REFUTED / UNVERIFIABLE.
- Aufbau eines Evidence Graph, der jede Bewertung auf ihre Quelle zurückverfolgt.
- Berechnung eines Trust Score auf Basis dieser Verifizierungen.
Es bearbeitet keinen Code und blockiert keine Merges und vermeidet es, Behauptungen ohne beigefügte Belege zu widerlegen.
Schlussfolgerung Das Tool scheint eine Verifizierungsschicht zu sein, keine Ersetzung für Agenten oder ein Tool für den Entwicklungsworkflow. Es ist als unabhängige Prüfung des Agentenverhaltens nach der Sitzung positioniert.
Positionierung & Claim-Entwicklung
Die Beschreibung besagt, dass RECEIPTS ein häufiges Versagensmuster im KI-Coding adressiert: Agenten, die selbstbewusste, aber unwahre Behauptungen aufstellen. Der Autor rahmt dies als ein Problem des Vertrauens – nicht nur im Code, sondern in den eigenen Aussagen des Agenten.
Behauptungen des Autors
- Agenten bewerten ihre eigene Hausarbeit ohne externe Prüfungen.
- Das Tool beseitigt die Notwendigkeit, Diffs manuell erneut zu lesen oder Testsuites erneut auszuführen.
- Es liefert deterministische, reproduzierbare Ergebnisse ohne Vermutungen.
- „UNVERIFIABLE“ ist eine Funktion, keine Schwäche.
Schlussfolgerung Die Positionierung ist die einer Vertrauensebene für KI-Agenten, gerichtet an Entwickler, die Gewissheit darüber haben möchten, dass von Agenten generierte Arbeit genau und überprüfbar ist. Das Tool ist als Sanity-Check-Mechanismus positioniert, nicht als Ersetzung oder Erweiterung des Agenten selbst.
Zielkunde & ICP
Die Beschreibung nennt keine spezifischen Kunden oder Personas. Sie impliziert jedoch:
- Entwickler, die mit KI-Coding-Agenten arbeiten.
- Teams oder Einzelpersonen, die sich auf von Agenten generierten Code verlassen und dessen Korrektheit validieren möchten.
- Nutzer von Tools wie Codex, Claude Code, OpenHands usw., die sich über falsche Behauptungen Sorgen machen.
Schlussfolgerung Die ICP sind wahrscheinlich Entwickler oder Engineering-Teams, die KI-Agenten nutzen, insbesondere solche, die sich in der frühen Phase der Adoption oder im Experimentieren mit agentenbasierten Workflows befinden. Das Tool wird nicht als auf Unternehmenskunden oder großflächige Implementierung ausgerichtet beschrieben.
Business Model & Preisbelege
In der Beschreibung werden keine Belege für Preise, Monetarisierung oder Geschäftsmodell angegeben.
Schlussfolgerung Das Projekt ist derzeit ein Hackathon-Prototyp, und es wurde kein kommerzielles Modell beschrieben. Es ist unklar, ob es als SaaS-Produkt, Open-Source-Tool oder internes Utility angeboten wird.
Technische & Auslieferungs-Signale
Der Autor gibt an, dass RECEIPTS mit Folgendem erstellt wurde:
- Tools: Codex, GPT-5.6, Docker, FastAPI, React, SQLite, TypeScript, Python.
- Architektur: ADRs (Architectural Decision Records), Plugin-SDK, sandboxed verifiers, Evidence Graph, Trust Score computation.
- Verifiers: Enthält pytest-Ausführung, AST-basierten Test-Tamper-Detektor, file-stat, scope-check, build/lint.
- Kern-Technologie: GPT-5.6 ist tragend für die Claim-Extraktion; gpt-5.6-sol und gpt-5.6-terra für verschiedene Aufgaben.
Schlussfolgerung Das Tool wurde mit einer modularen, erweiterbaren Architektur entwickelt, mit klarer Trennung zwischen Agent-Normalisierung, Claim-Extraktion, Verifizierung und Berichterstattung. Es nutzt deterministisches Sandboxing und schema-basierte Beurteilung.
Traction & Reifegrad-Signale
Die Beschreibung lautet:
- Das Tool wurde in einer Woche während eines Hackathons entwickelt.
- Es verfügt über 114/114 grüne Backend-Tests.
- Es verfügt über 8 funktionierende Session-Adapter.
- Es erzielte 100 % Präzision bei golden fixtures (REFUTED-precision = 1.000).
- Es enthält einen echten, digest-pinned Docker-Sandbox.
Schlussfolgerung Das Tool befindet sich in einem frühen Prototyp-Stadium und wird wahrscheinlich noch nicht im Produktivbetrieb eingesetzt. Der Autor betont seine Korrektheit und Reproduzierbarkeit, berichtet aber keine Nutzung über die Entwicklungsumgebung oder Nutzerfeedback hinaus.
Wettbewerbskontext
In der Projektdokumentation werden keine direkten Wettbewerber benannt oder beschrieben.
Schlussfolgerung RECEIPTS scheint ein neuartiges Konzept im Bereich der KI-Agenten zu sein, das eine Lücke im Bereich Vertrauen und Verifizierung adressiert. Es könnte mit Tools konkurrieren, die darauf abzielen, die Zuverlässigkeit von Agenten zu verbessern oder von Agenten generierten Code zu auditieren, aber es werden keine solchen Tools erwähnt.
Offene Fragen & Risiken
- Keine reale Nutzung: Das Tool wird als Hackathon-Prototyp beschrieben, ohne Hinweise auf eine Adoption.
- Hohe Abhängigkeit von GPT-5.6: Das System ist stark von einem Modell für die Claim-Extraktion abhängig – ein einzelner Ausfall- oder Begrenzungspunkt.
- Begrenzte Adapter-Unterstützung: Es werden nur 8 Adapter erwähnt, und die nächsten Schritte umfassen das Hinzufügen weiterer (Tier-2).
- Keine Monetarisierungsstrategie: Keine Hinweise darauf, wie es verkauft oder im großen Maßstab genutzt werden könnte.
Fragen, die die Beschreibung offenlässt
- Wie ist der aktuelle Stand des Tools über den Hackathon-Prototyp hinaus?
- Wurde es mit echten Nutzern oder Teams getestet, die KI-Agenten im Produktivbetrieb einsetzen?
- Wie behandelt es Grenzfälle, wie z. B. von Agenten generierten Code, der nicht leicht testbar ist?
- Gibt es einen Plan, das Tool als Open Source bereitzustellen oder es für eine breitere Nutzung verfügbar zu machen?
- Welche Auswirkungen auf Skalierbarkeit und Leistung hat das Ausführen von Verifiern in Docker-Sandboxes im großen Maßstab?
Gesamtbewertung
Nicht belegt.
Die Beschreibung liefert keine Informationen zu Umsatz, Kunden, Traction, Finanzierung oder Marktvalidierung. Es handelt sich um einen selbstberichteten Hackathon-Prototyp, nicht um ein kommerzielles Produkt oder Unternehmen.
Vertrauensgrad Niedrig. Diese Analyse basiert ausschließlich auf der eigenen Darstellung des Autors und mangelt an externer Bestätigung oder Belegen für reale Auswirkungen.
Umsetzen
Möchtest du etwas Ähnliches wie RECEIPTS bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit RECEIPTS oder seinen Autoren verbunden.
User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde vontop-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.