

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 1
Platz #1.624 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
 top-founders.comThis project's analysis was made with it
Check your idea against real competitors
Paste your competitors' URLs and get what to match, where to stand out and what to skip, with every claim linked to its source. Free, no credit card.
Trigger reports from Slack or MCP server.
Das Projekt auf Devpost anzeigen
Executive Summary
Company: Paprism
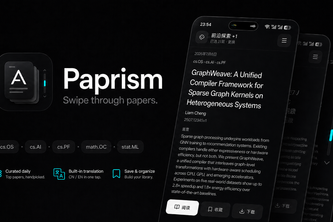
Selbstdeklarierte Zielsetzung: Eine mobile-first Forschungs- und Leseanwendung, die um einen vertikalen, durchwischbaren Paper-Feed aufgebaut ist und darauf ausgelegt ist, das Durchsuchen von arXiv-Papieren so natürlich zu gestalten wie moderne Content-Feeds, während das Originaldokument erhalten bleibt und KI-gestützte Funktionen wie Übersetzung und Frage-Antwort-Angebote bereitgestellt werden.
Was sich geändert hat: Das Projekt wird als eine Entwicklung von einem visuellen Prototyp zu einer funktionsfähigen, lokal installierbaren Anwendung mit einem vollständigen Workflow von der Entdeckung bis zum Lesen beschrieben. Es unterstützt lokale Speicherung, Offline-Lesen und nutzt eine OpenAI-kompatible API für Übersetzung und Q&A, ohne dass Benutzerkonten oder Backend-Dienste erforderlich sind.
Wichtigste offene Frage: Gibt es Belege für eine Nutzerakzeptanz, Engagement oder Traction über die eigenen Entwicklungsbemühungen des Autors hinaus?
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass Paprism eine mobile-first Forschungs- und Leseanwendung ist, die mit React Native, Expo, TypeScript und Bun entwickelt wurde. Es bietet:
- Einen vertikalen, durchwischbaren Paper-Feed zum Durchsuchen neu veröffentlichter arXiv-Papiere.
- Filterung nach Forschungsrichtung.
- Native Lesesicht ohne Wechsel zu externen Browser-Tabs.
- Strukturierte Blockübersetzung, die das Originaldokument erhält.
- Frage-Antwort-Funktion für ausgewählte Passagen.
- Lokale Speicherung gespeicherter Papiere, Historie und Offline-Downloads.
- Verwendung von OpenAI-kompatiblen API-Zugangsdaten, die lokal gespeichert werden.
- Keine Kontoerstellung und keine Datenübertragung an ein Backend.
Es ist so konzipiert, dass Nutzer Forschung leicht entdecken können, während der Zugriff auf das vollständige Paper erhalten bleibt. Die Anwendung kommuniziert direkt mit arXiv und verwendet keinen Anwendungsserver zwischen dem Nutzer und der Quelle.
Konfidenz: Hoch — dies ist eine selbstberichtete technische Beschreibung der Funktionsweise des Produkts, jedoch gibt es keine Belege für tatsächliche Nutzung oder Leistung.
Positionierung & Claim-Entwicklung
Der Autor behauptet, dass Paprism von der Frage ausging: „Wie würde eine Erfahrung in der Forschungsentdeckung aussehen, wenn sie so natürlich durchsuchbar wäre wie ein moderner Content-Feed, ohne Papiere zu wegwerflichem Inhalt zu reduzieren?“
Dies positioniert Paprism als Alternative zu traditionellen akademischen Datenbanken (die Vorkenntnisse voraussetzen) und passiven Content-Feeds (die auf Konsum statt auf Lernen optimiert sind). Der Name „Paprism“ spiegelt die Idee wider, Papiere in mehrere Ebenen des Verständnisses zu brechen: Metadaten, Zusammenfassungen, Übersetzung, Fragen, gespeicherte Referenzen und der Originaltext.
Das Projekt betont auch, dass es Quellmaterial nicht durch KI-Zusammenfassungen ersetzt, sondern stattdessen den Wechsel zwischen verschiedenen Ebenen der Beteiligung unterstützt — von schnellen Relevanzprüfungen bis hin zu tiefgehenden Untersuchungen.
Konfidenz: Mittel — dies ist eine selbstdeklarierte Positionierungs-Narrative; es werden keine externen Validierungen oder Marktrückmeldungen bereitgestellt.
Zielkunde & ICP
Die Beschreibung deutet darauf hin, dass die Zielgruppe Forscher, Studierende und Fachkräfte umfasst, die wissenschaftliche Publikationen effizient durchsuchen möchten, insbesondere solche, die an Veröffentlichungen auf arXiv interessiert sind. Die App ist für den mobilen Einsatz konzipiert, was auf eine Fokussierung auf Nutzer hindeutet, die Inhalte bevorzugt in ihrer Freizeit oder während der Pendelzeit konsumieren.
Sie richtet sich auch an Personen, die Datenschutz schätzen und keine persönlichen Daten mit Plattformen teilen möchten, die Konten erfordern oder Bibliotheksinformationen an Backends senden.
Konfidenz: Mittel — die Beschreibung nennt keine spezifischen Personas oder Segmente und beschreibt auch keine Kundeninterviews oder Feedback-Schleifen.
Business Model & Preisbelege
In der Beschreibung gibt es keine Hinweise auf ein Geschäftsmodell oder eine Preisstrategie. Die App wird als Unterstützung von local-first-Speicherung beschrieben und ermöglicht es Nutzern, ihre eigenen OpenAI-kompatiblen API-Zugangsdaten zu verwenden, ohne dass ein Konto erforderlich ist oder Daten an ein Backend gesendet werden. Es werden keine Monetarisierungsmechanismen, Abo-Pläne oder kostenpflichtige Funktionen erwähnt.
Konfidenz: Sehr niedrig — es gibt keine Hinweise darauf, wie das Unternehmen Einnahmen generieren möchte.
Technische & Auslieferungs-Signale
Die Anwendung wird mit folgenden Technologien entwickelt:
- React Native, Expo, TypeScript und Bun
- Direkte Kommunikation mit arXiv
- Kein Backend-Server zwischen Nutzer und Quelle
- Lokale Speicherung aller Daten (Papiere, Verlauf, Präferenzen, Übersetzungen)
- Strukturierte blockbasierte Übersetzungspipeline mit Validierung und Caching
- Dauerhafte Zustandswarteschlange, um die Persistenz vor der Meldung der Vollendung sicherzustellen
- Offline-Verarbeitung von Dokumenten und Lebenszyklusverwaltung von PDF-Downloads
Das Team erwähnt auch:
- Open-Source-Charakter des Projekts
- Automatisierte Tests, CI-Prüfungen, Multi-Architektur-Builds, GitHub-Releases
- Design für mobiles Lesen mit dunkler editorischer UI
- Behandlung komplexer Interaktionen wie Wischgesten innerhalb von scrollbarem Text
Konfidenz: Hoch — eine detaillierte technische Architektur wird beschrieben, jedoch gibt es keine Hinweise auf eine Produktivbereitstellung oder Skalierbarkeit.
Traction & Reifegrad-Signale
Die Beschreibung besagt, dass das Projekt über ein visuelles Prototyp hinausgewachsen ist und nun eine funktionsfähige, lokal installierbare Anwendung mit einem vollständigen Workflow von der Entdeckung bis zum Lesen darstellt. Sie umfasst:
- Vollständige Offline-Lesestütze
- Blockbasierte Übersetzung
- Local-first-Design
- Open-Source-Veröffentlichung
Es gibt jedoch keine Hinweise auf Nutzerakzeptanz, aktive Nutzungsdaten oder Kundenfeedback.
Konfidenz: Niedrig — das Projekt scheint in der Entwicklung reif zu sein, weist aber keine Indikatoren für Traction auf.
Wettbewerbskontext
Die Beschreibung erwähnt keine Wettbewerber. Basierend auf den Funktionen (durchwischbares Forschungs-Feed, Übersetzung, Offline-Lesen) könnte es jedoch positioniert werden gegen:
- Traditionelle akademische Datenbanken wie Semantic Scholar, Google Scholar
- Inhaltsfeeds, die für passiven Konsum optimiert sind (z. B. TikTok, YouTube)
- Andere KI-gestützte Werkzeuge für die Forschung wie ChatGPT, Claude oder ResearchRabbit
Es wird keine Wettbewerbsanalyse oder Differenzierungsstrategie bereitgestellt.
Konfidenz: Niedrig — keine Erwähnung bestehender Lösungen oder einer Wettbewerbspositionierung.
Offene Fragen & Risiken
- Keine Einnahmen oder Monetarisierungsstrategie – Die App scheint Open-Source und kostenlos zu sein, ohne Hinweise darauf, wie sie skaliert oder Einnahmen generiert.
- Ein-Personen-Team – Das Projekt wird von einer Person (Alan Wake) entwickelt, was Bedenken hinsichtlich der langfristigen Wartung und Skalierbarkeit aufwirft.
- Local-first-Ansatz kann das Wachstum einschränken – Die lokale Speicherung aller Daten bedeutet eine begrenzte Fähigkeit, Community-Funktionen, Analysen oder die Synchronisierung über Geräte hinweg zu erstellen.
- Risiken bei der KI-Integration – Die Abhängigkeit von strukturierten KI-Antworten birgt das Risiko einer Fehlausrichtung zwischen Prompts und Ausgaben ohne robuste Validierung.
- Keine Nutzerfeedbacks oder Adoptionsdaten – Trotz des Status als Produkt für Forscher gibt es keine Belege für eine tatsächliche Nutzung oder Wirkung in der Praxis.
Konfidenz: Mittel – dies sind abgeleitete Risiken aus der selbstberichteten Beschreibung; sie werden nicht ausdrücklich genannt, können aber vernünftigerweise abgeleitet werden.
Fragen, die die Beschreibung offenlässt
- Was ist Ihr Plan zur Monetarisierung oder Skalierung über einen einzelnen Entwickler hinaus?
- Wie beabsichtigen Sie, Nutzer in einem Nischenmarkt wie der akademischen Forschung anzuziehen und zu binden?
- Haben Sie in Betracht gezogen, wie der Local-first-Ansatz die langfristige Datenmigration oder -wiederherstellung beeinflussen könnte?
- Welche Einschränkungen gibt es bei der Nutzung von OpenAI-kompatiblen APIs, insbesondere im Hinblick auf Rate Limits oder Kosten?
- Gibt es Pläne zur Erweiterung über arXiv hinaus oder zur Integration mit anderen Quellen?
- Wie planen Sie, Sonderfälle bei der Übersetzung (z. B. mathematische Notation) zu handhaben?
- Wurde die App von tatsächlichen Forschern oder Studierenden getestet?
- Was sind Ihre Gedanken zum Aufbau einer Community oder Plattform rund um das Tool?
Gesamtbewertung
nicht belegt – Es gibt keine Belege für Einnahmen, Kunden oder Traction über die eigenen Entwicklungsbemühungen des Autors hinaus.
Das Projekt zeigt eine starke technische Umsetzung und eine klare Vision zur Verbesserung des Zugangs zu Forschung durch mobile-first Design und KI-Integration. Ohne jegliche Anzeichen von Nutzeradoption, Engagement oder Klarheit im Geschäftsmodell bleibt es jedoch ein experimenteller Prototyp mit Potenzial, aber ungewiesener kommerzieller Tragfähigkeit.
Bewertung: Zu diesem Zeitpunkt nicht bereit für Investitionen oder Partnerschaften, es sei denn, es treten weitere Belege für Traction, Marktfähigkeit oder eine Monetarisierungsstrategie zutage.
Umsetzen
Möchtest du etwas Ähnliches wie Paprism bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Paprism oder seinen Autoren verbunden.
User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde vontop-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.