

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #5.467 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
 top-founders.comThis project's analysis was made with it
Check your idea against real competitors
Paste your competitors' URLs and get what to match, where to stand out and what to skip, with every claim linked to its source. Free, no credit card.
Trigger reports from Slack or MCP server.
Das Projekt auf Devpost anzeigen
Executive Summary
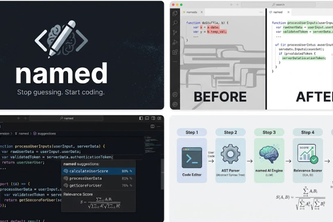
Die Beschreibung besagt, dass "named" eine kontextuelle semantische Benennungsmaschine ist, die entwickelt wurde, um Entwicklern bei der Generierung lesbarer, konventionskonformer Namen für Variablen, Funktionen und Klassen zu helfen, indem sie den Codekontext mithilfe eines Abstract Syntax Tree (AST) und Large Language Models (LLMs) analysiert. Es wurde im Rahmen einer Hackathon-Einreichung erstellt und weist keine nachgewiesene Nachfrage, Einnahmen oder Kundendaten auf. Die wichtigste offene Frage ist, ob das Produkt eine ausreichende technische Machbarkeit und kommerzielle Tragfähigkeit aufweist, um weitere Due-Diligence-Maßnahmen zu rechtfertigen.
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass "named" eine kontextuelle semantische Benennungsmaschine ist. Sie fungiert als intelligenter Coding-Begleiter, der den Abstract Syntax Tree (AST) und den umgebenden Codekontext analysiert, um hochgradig lesbare, konventionskonforme Namen für Variablen, Funktionen und Klassen vorzuschlagen. Sie verwendet FastAPI (Python) für die Backend-Logik, React mit TailwindCSS für das Frontend und integriert LLMs, um Vorschläge auf der Grundlage der semantischen Ähnlichkeit zwischen den Embeddings der generierten Namen und den Embeddings der Code-Dokumentation zu erzeugen.
Positionierung & Claim-Entwicklung
Die Beschreibung besagt, dass "named" darauf abzielt, das Problem der schlechten Benennung in Codebasen zu lösen, was zu technischer Schuld und verwirrendem Code führt. Es positioniert sich als intelligenter Coding-Begleiter, der die kognitive Belastung für Entwickler eliminiert, damit sie sich auf Architektur und Logik konzentrieren können. Der Autor bezieht sich auf das Zitat von Phil Karlton, wonach Benennung eine der zwei schwierigsten Dinge in der Informatik sei, was auf eine Behauptung hindeutet, einen grundlegenden Schmerzpunkt von Entwicklern zu lösen.
Zielkunde & ICP
Die Beschreibung besagt, dass "named" an Entwickler gerichtet ist, die Schwierigkeiten haben, Variablen, Funktionen und Klassen zu benennen. Es richtet sich an diejenigen, die eine kognitive Belastung erleben, wenn sie versuchen, komplexe Logik in knappe Variablennamen zu fassen. Das Produkt scheint für Einzelentwickler konzipiert zu sein, die in Codebasen arbeiten, anstatt für Teams oder Organisationen.
Business Model & Preisbelege
Nicht nachgewiesen. Die Beschreibung enthält keine Informationen über Preismodelle, Monetarisierungsstrategien oder Annahmen zum Geschäftsmodell.
Technische & Auslieferungs-Signale
Die Beschreibung besagt, dass das Backend mit FastAPI (Python) erstellt wurde und das Frontend React und TailwindCSS verwendet. Es erwähnt die Verwendung von LLMs zur Namenserzeugung und die Berechnung der semantischen Ähnlichkeit über die Kosinusähnlichkeit zwischen Embeddings. Das System verwendet einen benutzerdefinierten Chunking-Algorithmus, um relevanten Codekontext zu extrahieren, ohne die Token-Grenzen zu überschreiten, und umfasst Prompt Engineering, um spezifische Benennungskonventionen wie camelCase oder snake_case durchzusetzen.
Traction & Reifegrad-Signale
Nicht nachgewiesen. In der Beschreibung gibt es keine Informationen über Nutzer, Kunden, Einnahmen, Adoption oder andere Traction-Metriken, abgesehen von ihrem Status als Hackathon-Einreichung.
Wettbewerbskontext
Nicht nachgewiesen. Die Beschreibung erwähnt keine Wettbewerber, bestehende Lösungen in diesem Bereich oder wie "named" sich im Vergleich zu anderen Tools oder Ansätzen für die Unterstützung bei der Codebenennung verhält.
Offene Fragen & Risiken
- Das Produkt wird als Hackathon-Einreichung beschrieben, die keine nachgewiesene Nachfrage oder kommerzielle Tragfähigkeit aufweist.
- Es stützt sich stark auf LLMs und Berechnungen der Ähnlichkeit von Embeddings, was für den Produktiveinsatz möglicherweise nicht robust genug ist.
- Der benutzerdefinierte Chunking-Algorithmus zur Verwaltung von Token-Limits deutet auf potenzielle Skalierbarkeits- oder Genauigkeitsprobleme hin.
- Es gibt keine Hinweise auf ein Geschäftsmodell, eine Preisgestaltung oder eine Monetarisierungsstrategie.
- Die Teamgröße ist mit einem Mitglied angegeben, was Fragen zur Entwicklungskapazität und Ausführungsfähigkeit aufwirft.
Fragen, die die Beschreibung offenlässt
- Welche spezifischen technischen Herausforderungen sind Ihnen bei der Implementierung der semantischen Ähnlichkeitsberechnungen und der embedding-basierten Namensauswahl begegnet?
- Wie planen Sie, diese Lösung über den Anwendungsfall eines einzelnen Entwicklers hinaus zu skalieren?
- Haben Sie das System mit realen Codebasen getestet oder nur mit synthetischen Beispielen?
- Was ist Ihre Roadmap, um von einem Hackathon-Prototyp zu einem tragfähigen Produkt zu gelangen?
- Wie beabsichtigen Sie, dieses Tool zu monetarisieren, und welche Marktforschung stützt diesen Ansatz?
Gesamtbewertung
Nicht belegt. Die Beschreibung enthält keine Informationen zu Finanzen, Finanzierungsrunden, Bewertung oder einer Grundlage für Investitions- oder Partnerschaftsüberlegungen. Das Projekt wird als Hackathon-Einreichung beschrieben, ohne nachgewiesene Traction oder kommerzielle Tragfähigkeit.
Umsetzen
Möchtest du etwas Ähnliches wie named bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit named oder seinen Autoren verbunden.
User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde vontop-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.