

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #5.241 von 7.846 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Wofür das Unternehmen offenbar steht
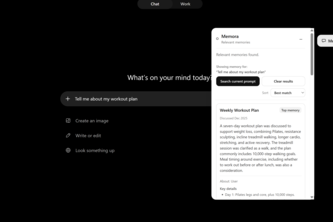
Memora ist ein selbstberichteter persönlicher KI-Memory-Companion, der als lokale Chrome-Erweiterung und FastAPI-Backend entwickelt wurde. Der Autor gibt an, dass es Nutzern hilft, den Gesprächsverlauf und den Dokumentenkontext über ChatGPT-Sitzungen hinweg zu verwalten, indem Informationen in MemoryThreads, MemoryFacts und MemoryBriefs organisiert werden, mit zeitlicher Schlussfolgerung und Herkunftsverfolgung.
Was sich geändert hat
Das Projekt entwickelte sich von einer grundlegenden RAG (Retrieval-Augmented Generation) zu einer komplexeren Architektur, die Memory-Threading, zeitliche Schlussfolgerung, Korrekturbehandlung und Synthese umfasst. Es wurde als persönliche Lösung für das eigene Problem des Autors entwickelt, nämlich verstreute Gespräche in ChatGPT.
Wichtigste offene Frage
Gibt es Belege dafür, dass Memora über den einzelnen Entwickler, der es erstellt hat, hinaus eine bedeutende Verbreitung oder Adoption erreicht hat? Die selbstberichtete Beschreibung enthält keine Daten zu Nutzern, Umsatz, Kunden oder Nutzungsmetriken.
Analysegrundlage
Dieser Bericht basiert ausschließlich auf der eigenen Beschreibung von Memora durch den Autor. Es sind keine externen Verifizierungen, archivierte Daten, Drittanbieterquellen oder unabhängige Bestätigungen verfügbar. Alle Aussagen in diesem Dokument sind selbstberichtet und unbestätigt.
Was das Produkt tatsächlich ist
Die Beschreibung gibt an, dass Memora ist:
- Ein nutzerkontrollierter Companion für ChatGPT
- Eine lokale Chrome-Erweiterung (Manifest V3), die neben ChatGPT funktioniert
- Ein FastAPI-Backend, das die Abfrage und die Memory-Verarbeitung handhabt
- Eine SQLite-Datenbank, die importierte Gespräche, Chunks, Embeddings, Dokumente, Zeitstempel und Herkunft speichert
Das System wird als mit einer Abfrage-Pipeline beschrieben, die Folgendes umfasst:
- Semantische Abfrage
- Hybrides Reranking
- MemoryThreads
- MemoryFacts
- Zeitliche Schlussfolgerung
- MemoryBriefs
- Herkunftsverfolgung
Es unterstützt auch:
- Erweiterte und lokale Verarbeitungsmodi
- Wiederherstellbare Text-PDFs und Anhänge
- Einen Ein-Befehls-Windows-Startprogramm für die Umgebungssetup, Abhängigkeiten, Erweiterungsbuilds, Authentifizierung und Backend-Start
Schlussfolgerung Das Produkt scheint ein persönliches Werkzeug für den individuellen Gebrauch zu sein, nicht ein kommerzielles SaaS-Angebot. Es wird als nur lokal beschrieben, ohne Erwähnung von Cloud-Infrastruktur oder Mehrbenutzerunterstützung.
Positionierung & Claim-Entwicklung
Der Autor gibt an, dass Memora entwickelt wurde, um ein persönliches Problem zu lösen:
- "Ich habe mich entschieden, Memora zu bauen, weil ich, je länger ich ChatGPT nutzte, umso mehr verstreute Gespräche über dasselbe Thema überall hatte"
- "Ich wollte Zugang zu den relevantesten Informationen und Kontrolle über die verschiedenen Versionen desselben Themas"
Die Positionierung ist:
- Persönlicher KI-Memory-Companion
- Kein Ersatz für LLMs, sondern ein Companion, der Nutzern hilft, zu finden, was aus ihrer Historie tatsächlich relevant ist
- Nutzerkontrolliert: "Memora fügt oder sendet nie stillschweigend etwas ein. Der Nutzer prüft die Ergebnisse, wählt 'Use This Context' aus, prüft den aktualisierten Entwurf und sendet die Nachricht manuell."
Schlussfolgerung Das Produkt ist als persönliches Produktivitätswerkzeug positioniert, nicht als kommerzielle Plattform. Es entwickelte sich von einer grundlegenden RAG zu einem ausgefeilteren System, das Kontext über Zeit und Projekte hinweg organisiert.
Zielkunde & ICP
Die Beschreibung gibt an:
- Memora ist für Nutzer von ChatGPT entwickelt
- Konkret richtet es sich an Nutzer, die verstreute Gespräche über dasselbe Thema führen
- Nutzer, die Kontrolle über ihr KI-Gedächtnis wünschen, nicht nur die Abrufung früherer Nachrichten
- Der eigene Anwendungsfall des Autors: "Ich habe an einem Projekt gearbeitet, bei dem ich ein spezifisches Gespräch mit einer bestimmten Architektur hatte, und nach Monaten beschloss ich, das gesamte Projekt mit einer anderen Architektur neu zu machen"
Schlussfolgerung Der Zielkunde ist wahrscheinlich technische Fachkräfte oder Entwickler, die ChatGPT für langfristige Projekte nutzen, aber es gibt keine Belege für ein identifiziertes Marktsegment jenseits der persönlichen Erfahrung einer Person.
Business Model & Preisbelege
Die Beschreibung lautet:
- Memora ist ein ausschließlich lokales Projekt
- Es erfordert, dass Nutzer ein GitHub-Repository klonen und Befehle auf einem Computer ausführen
- Der Autor sagt: "Ich möchte von einem rein lokalen Service zu einem zugänglicheren Produkt übergehen, während ich denselben Fokus auf Datenschutz und Nutzerkontrolle beibehalte"
Schlussfolgerung Es gibt keine Belege für ein Preismodell, eine Monetarisierungsstrategie oder ein Geschäftsmodell. Der Autor stellt ausdrücklich fest, dass es sich noch nicht um ein kommerzielles Angebot handelt.
Technische & Auslieferungs-Signale
Die Beschreibung lautet:
- Entwickelt mit: api, embeddings, esbuild, fastapi, javascript, manifest-v3, node.js, openai-api, pypdf, python, rag, sqlite, typescript, vector-search
- Verwendet eine dreiteilige Architektur: Chrome-Erweiterung, FastAPI-Backend, SQLite-Datenbank
- Die Abrufpipeline umfasst: semantische Abrufung → hybrides Reranking → MemoryThreads → MemoryFacts → temporale Schlussfolgerung → MemoryBriefs → Herleitung
- Unterstützt PDFs und Anhänge
- Enthält einen Windows-Startprogramm für die Einrichtung
Schlussfolgerung Der technische Stack ist mit persönlichen Entwicklungswerkzeugen konsistent, nicht mit unternehmensweiter Infrastruktur. Er wird als ausschließlich lokal beschrieben, was auf keinen Cloud- oder Mehrbenutzer-Support hindeutet.
Traction & Reifegrad-Signale
Die Beschreibung lautet:
- Von einer Person entwickelt (suheil2004 Almouhassel)
- Eingereicht beim OpenAI 2026 Hackathon
- Keine Erwähnung von Nutzern, Kunden, Umsatz oder Verbreitung
- Der Autor sagt: "Ich bin am stolzesten darauf, dass ich ein Problem, das ich tatsächlich hatte, in eine Produktidee verwandeln und etwas bauen konnte, das es für mich tatsächlich löst"
- Der nächste Schritt ist, es für jedermann zugänglich zu machen, nicht nur für lokale Nutzer
Schlussfolgerung Es gibt keine Belege für Traction oder Verbreitung jenseits des einzelnen Entwicklers. Es werden keine Metriken, Nutzerdaten oder Kundenfeedback bereitgestellt.
Wettbewerbskontext
Die Beschreibung erwähnt keine Wettbewerber oder Marktkontext. Sie besagt nur:
- Der Autor begann mit grundlegenden RAG-Konzepten
- Entwickelte sich zu einem komplexeren System mit MemoryThreads, temporaler Schlussfolgerung und Synthese
Schlussfolgerung Eine Wettbewerbsanalyse ist nicht erkennbar. Das Produkt scheint in seinem Ansatz einzigartig zu sein, mangelt aber an Belegen für eine Marktpositionierung oder Konkurrenz.
Offene Fragen & Risiken
- Einzelne Person entwickelt: Es werden kein Team oder externe Mitwirkende erwähnt
- Keine Traction oder Verbreitung: Keine Nutzer-, Kunden- oder Umsatzdaten
- Ausschließlich lokale Lösung: Nicht skalierbar für den kommerziellen Einsatz ohne umfassende Neugestaltung
- Ungeprüfte Aussagen: Alle Beschreibungen sind selbst gemeldet und ungeprüft
- Kein Preis- oder Monetarisierungsmodell: Unklarer Weg zur kommerziellen Tragfähigkeit
Schlussfolgerung Das Projekt befindet sich in einem sehr frühen Stadium, vermutlich handelt es sich um einen Prototyp oder ein persönliches Werkzeug. Es gibt keine Hinweise auf kommerzielle Reife oder Skalierbarkeit.
Fragen, die die Beschreibung offenlässt
- Welche spezifischen Nutzerprobleme lösen Sie abgesehen von den eigenen?
- Wie planen Sie den Übergang von einer rein lokalen Lösung zu einem skalierbaren Produkt?
- Haben Sie das Produkt mit anderen Nutzern getestet und welches Feedback haben Sie erhalten?
- Was ist Ihre Roadmap für Monetarisierung oder kommerzielle Tragfähigkeit?
- Gibt es technische Einschränkungen, die verhindern, dass dies ein cloudbasierter Dienst wird?
Gesamtbewertung
Nicht belegt.
Die Beschreibung liefert keine Hinweise auf:
- Umsatz
- Kunden
- Traction
- Marktvalidierung
- Kommerzielle Reife
- Skalierbarkeit
- Teamgröße über eine Person hinaus
Schlussfolgerung Dies ist ein persönliches Projekt, kein kommerzielles Vorhaben. Es gibt kein nachgewiesenes Geschäftsmodell oder Markttraktion. Das vom Autor formulierte Ziel ist es, das Projekt für andere zugänglich zu machen, jedoch gibt es keine Hinweise auf Fortschritte in Richtung dieses Ziels.
Umsetzen
Möchtest du etwas Ähnliches wie Memora bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Memora oder seinen Autoren verbunden.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.