

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 1
Platz #1.223 von 7.847 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.585 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Wofür das Unternehmen offenbar steht
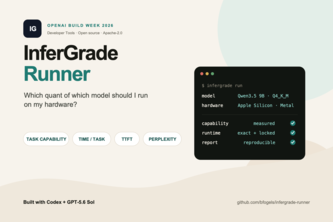
InferGrade Runner ist ein selbstberichtetes Tool zum Benchmarking quantisierter GGUF-Modelle auf lokaler Hardware. Der Autor, Brian Fogelson, beschreibt es als einen automatisierten Capability-Benchmark, der Modelle direkt auf den Maschinen der Nutzer ausführt und Leistungskennzahlen wie Zeit pro Aufgabe, Perplexity, TTFT und Speichernutzung meldet. Es unterstützt Apple Silicon mit nativer llama.cpp + Metal-Beschleunigung sowie containerisierte Pfade für Nvidia/AMD-GPUs.
Was sich geändert hat
Das Projekt entwickelte sich während des OpenAI 2026 Hackathons von einem persönlichen Workflow-Tool zu einem öffentlich zugänglichen Produkt. Der Autor berichtet, dass er GPT-5.6 (via Codex) nutzte, um Code umzustrukturieren, Fixes zu implementieren, Tests hinzuzufügen und Releases in einem kurzen Zeitraum (13.–21. Juli) vorzubereiten. Dies umfasste architektonische Verbesserungen wie signierte Runtime-Kataloge, unveränderliche Runtime-Locks und Checkpointing für langlaufende Benchmarks.
Wichtigste offene Frage
Gibt es Hinweise auf Traction, Adoption oder Nutzung über die eigene Entwicklung und das eigene Testing des Autors hinaus?
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass InferGrade Runner:
- Quantisierte GGUF-Modelle auf lokaler Hardware ausführt.
- Leistungskennzahlen misst, einschließlich Zeit pro Aufgabe, Time to First Token (TTFT), Generierungsgeschwindigkeit, Speichernutzung und Perplexity.
- Markdown-Berichte und strukturierte Ergebnisbündel zur Überprüfung durch den Nutzer erstellt.
- Apple Silicon nativ mit llama.cpp + Metal-Beschleunigung unterstützt.
- Docker-Container für Benchmarks auf Nvidia/AMD-GPUs verwendet.
- Hauptsächlich in Python und Rust entwickelt, mit einer Tauri-Desktop-App-Oberfläche.
Schlussfolgerung Das Tool scheint ein lokales Benchmarking-Utility für Entwickler zu sein, die mit lokalen LLMs arbeiten. Es wird nicht als Marktplatz oder Plattform beschrieben, sondern als ein in sich geschlossenes Tool zur Bewertung der Modellleistung auf spezifischer Hardware.
Positionierung & Claim-Entwicklung
Der Autor behauptet:
- Lokale Modelle sind für Entwickler-Workflows wichtig, insbesondere für Offline-Arbeit und zur Vermeidung von API-Kosten.
- Die Auswahl der zu verwendenden quantisierten Version eines Modells bleibt aufgrund des Mangels an zuverlässigen lokalen Benchmarks schwierig.
- Bestehende Benchmarks (z. B. Open LLM Leaderboard) beantworten nicht die Frage: „Welche Quantisierung welches Modells sollte ich auf meiner Hardware ausführen?“
- InferGrade Runner schließt diese Lücke, indem es tatsächliche Modelle lokal ausführt und reale Leistungswerte meldet.
Schlussfolgerung Die Positionierung konzentriert sich auf die Lösung eines Nischenproblems in der lokalen LLM-Nutzung – Entwicklern dabei zu helfen, fundierte Entscheidungen über Quantisierungsoptionen auf Basis ihrer Hardware zu treffen. Es ist als Utility positioniert, nicht als Plattform oder Marktplatz.
Zielkunde & ICP
Die Beschreibung besagt:
- Das Tool richtet sich an Entwickler, die mit lokalen Modellen arbeiten.
- Diese Nutzer könnten sich um Offline-Zugang, Kostenkontrolle und Leistungskompromisse kümmern.
- Der Autor erwähnt, dass er oft auf Reddit-Posts und Hugging Face-Notizen zurückgreift, um Entscheidungen zu treffen – was auf eine technisch versierte, aber nicht unbedingt unternehmensbezogene oder großskalige Nutzerbasis hindeutet.
Schlussfolgerung Die ICP umfasst wahrscheinlich Einzelentwickler oder kleine Teams, die lokale LLMs für Forschung, Prototyping oder Entwicklung nutzen. Es gibt keine Hinweise auf Unternehmenskunden oder B2B-Adoption.
Business Model & Preisbelege
Nicht belegt.
Erläuterung
In der Beschreibung wird weder ein Preis, eine Monetarisierungsstrategie noch ein Geschäftsmodell erwähnt. Das Projekt wird als Open Source (Apache-2.0-Lizenz) und öffentlich auf Devpost verfügbar beschrieben.
Technische & Auslieferungs-Signale
Die Beschreibung lautet:
- Entwickelt mit Python, Rust, Tauri, Docker, llama.cpp, Hugging Face, GPT-5.6 (via Codex) und anderen Technologien.
- Das Tool wurde von Python auf Rust migriert, um die Installation und Abhängigkeitsverwaltung zu erleichtern.
- Verwendet JSON-Schemas zur Definition von Ergebnisformaten.
- Implementiert Checkpointing, Runtime-Identity-Locking, signierte Kataloge und unveränderliche Runtimes.
- Unterstützt Apple Silicon nativ mit Metal-Beschleunigung; containerisierte Pfade für Nvidia/AMD.
Schlussfolgerung Der technische Stack deutet auf ein reifes, gut durchdachtes Tool hin, das Benutzerfreundlichkeit und Leistung ausbalanciert. Die Verwendung von GPT-5.6 in der Entwicklung zeigt einen experimentellen oder iterativen Ansatz zum Aufbau und zur Verfeinerung des Produkts.
Traction & Reifegrad-Signale
Nicht belegt.
Erläuterung
Es gibt keine Hinweise auf Umsatz, Kunden, Nutzerbasis oder Adoption über die eigene Entwicklung und das eigene Testen des Autors hinaus. Das Projekt wurde für einen Hackathon eingereicht und wird als öffentlich und Open Source beschrieben, es werden jedoch keine Metriken oder Nutzungsdaten angegeben.
Wettbewerbskontext
Die Beschreibung erwähnt:
- Projekte wie das Open LLM Leaderboard und Artificial Analysis als Inspirationen.
- Diese Benchmarks konzentrieren sich auf allgemeine Fähigkeitsvergleiche statt auf die Leistung lokaler Hardware.
- InferGrade Runner schließt eine Lücke, indem es lokale, hardware-spezifische Benchmarks bereitstellt.
Schlussfolgerung Es konkurriert mit Allzweck-LLM-Benchmarking-Tools, konzentriert sich jedoch spezifisch auf die Bewertung lokaler Modelle. Die Wettbewerbslandschaft umfasst Open-Source- und kommerzielle Benchmarking-Plattformen, wobei keine direkt benannt werden.
Offene Fragen & Risiken
- Keine Hinweise auf Traction oder Adoption: Das Tool wird als persönliches Projekt beschrieben, das sich während eines Hackathons entwickelt hat; es gibt keine Anzeichen für eine Nutzung in der Praxis.
- Nur selbst gemeldet: Alle Aussagen sind unbestätigt und basieren auf der eigenen Darstellung des Autors.
- Begrenzte Hardwareunterstützung: Nur Apple Silicon verfügt über native Beschleunigung; andere Plattformen sind auf Container angewiesen, was die Nutzbarkeit einschränken kann.
- Unklare Skalierbarkeit oder langfristige Vision: Der Autor merkt an, dass „das nächste Ziel darin besteht, den ersten erfolgreichen Lauf langweilig zu machen“, was auf einen Fokus auf Benutzerfreundlichkeit statt auf Skalierung hindeutet.
Fragen, die die Beschreibung offenlässt
- Was sind die tatsächlichen Leistungsunterschiede zwischen den von Ihnen getesteten Quantisierungen und wie variieren sie je nach Hardware?
- Wie geht InferGrade Runner mit Kompatibilitätsproblemen von Modellen oder Laufzeitfehlern während des Benchmarkings um?
- Gibt es Pläne, über Apple Silicon hinauszugehen oder Unterstützung für Windows-Umgebungen hinzuzufügen?
- Wurde das Tool von anderen Personen außerhalb Ihrer eigenen Entwicklungsumgebung verwendet?
- Was ist die langfristige Roadmap für das Projekt und wie planen Sie, es aufrechtzuerhalten?
Gesamtbewertung
Nicht belegt.
Erläuterung
Es gibt keine Belege für Umsatz, Finanzierung oder kommerzielle Traction, die eine Investitions- oder Partnerschaftsentscheidung stützen könnten. Das Projekt wird als persönliches Werkzeug beschrieben, das sich während eines Hackathons entwickelt hat, ohne Hinweise auf Marktnachfrage oder ein Geschäftsmodell jenseits der Open-Source-Verfügbarkeit. Jegliches Potenzial für eine Investition oder Partnerschaft würde eine weitere Due-Diligence-Prüfung der Nutzerakzeptanz, Skalierbarkeit und Monetarisierungsstrategie erfordern.
Umsetzen
Möchtest du etwas Ähnliches wie InferGrade Runner bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit InferGrade Runner oder seinen Autoren verbunden.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.