

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #4.982 von 7.848 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.585 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 132 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Wofür das Unternehmen offenbar steht
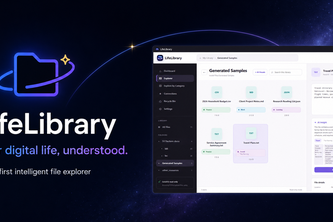
LifeLibrary ist ein selbstberichteter Windows-Desktop-Dateiexplorer, der KI-gestützte Intelligenz hinzufügt, um Benutzern zu helfen, ihre Dateien anhand von Bedeutung statt nach Name oder Ort zu verstehen, zu durchsuchen und zu organisieren. Es integriert lokale oder cloudbasierte KI-Modelle (z. B. LM Studio oder GPT-5.6), um Zusammenfassungen zu erstellen, zu kategorisieren, zu taggen und Beziehungen zwischen Dateien zu visualisieren. Das Produkt wird als Werkzeug für Einzelpersonen und kleine Teams beschrieben, die eine intelligentere, aber vertraute Erfahrung beim Durchsuchen von Dateien suchen.
Was sich geändert hat
Der Autor gibt an, dass LifeLibrary den traditionellen Dateiexplorer neu denkt, indem es KI-Verständnis einbettet, ohne das Dateisystem zu ersetzen. Es bewahrt Verzeichnisstrukturen und native Dateioperationen, während es semantische Suche, persistente Kategorisierung und visuelle Erkundung von Dateibeziehungen einführt.
Wichtigste offene Frage
Gibt es Hinweise auf tatsächliche Nutzerakzeptanz oder Traction über die eigene Entwicklung des Autors und die Einreichung zu einem Hackathon hinaus?
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass LifeLibrary ein Windows-Desktop-Dateiexplorer ist, der mit Electron, Node.js, HTML, CSS und JavaScript entwickelt wurde. Es ermöglicht Benutzern:
- Ordner durchzublättern und Dateien voranzusehen.
- Dokumente mit lokaler KI (z. B. LM Studio) oder cloudbasierten Modellen (z. B. GPT-5.6) zu analysieren.
- Inhalte aus PDF-, DOCX-, PPTX-, CSV-, JSON-, Markdown- und Textdateien zu extrahieren.
- In Dateinamen, Zusammenfassungen, Kategorien, Tags und KI-Nachweisen zu suchen.
- Dateibeziehungen in einem zoombaren „Datei-Universum“ zu visualisieren.
- Echte Dateipfade, Miniaturansichten und natives Öffnungsverhalten beizubehalten.
Es wird beschrieben, dass es das Dateisystem nicht ersetzt, sondern es mit KI-Verständnis erweitert. Das Produkt umfasst Funktionen wie persistente Indizierung, adaptive Taxonomie und Wiederherstellungsworkflows (z. B. Papierkorb).
Schlussfolgerung Der Autor behauptet, dass es sich um eine ausführbare Desktop-Anwendung handelt, es gibt jedoch keine Hinweise auf öffentliche Verfügbarkeit oder Verbreitung über die Devpost-Einreichung hinaus.
Positionierung & Claim-Entwicklung
Die Beschreibung besagt, dass LifeLibrary sich positioniert als:
- Eine persönliche Wissensschicht über dem Dateisystem.
- Eine Alternative zu traditionellen Dateiverwaltungswerkzeugen, die sich auf starre Verzeichnisstrukturen oder undurchsichtige KI-Automatisierung verlassen.
- Ein Werkzeug, das Vertrautheit (Ordner, Doppelklick zum Öffnen) bewahrt, während es Intelligenz hinzufügt.
Es betont drei Prinzipien:
- Vertraut: Dateien bleiben Dateien; Ordner bleiben Ordner.
- Erklärbar: KI-Ausgaben umfassen Zusammenfassungen, Konfidenz, Tags und Nachweise.
- Privat nach Wahl: Benutzer können lokale oder cloudbasierte KI-Verarbeitung wählen.
Schlussfolgerung Die Positionierung spiegelt einen Wandel von Datei-Scan-Werkzeugen zu einem intelligenten Datei-Browser wider, der KI in alltägliche Workflows integriert. Der Anspruch, „eine persönliche Wissensbetriebsschicht“ zu sein, ist jedoch selbstberichtet und mangelt an Traction-Daten.
Zielkunde & ICP
Die Beschreibung besagt, dass LifeLibrary nützlich ist für:
- Studenten
- Forscher
- Kreative
- Familien
- Freelancer
- Kleine Teams
Es wird als Werkzeug beschrieben, das von einem persönlichen Desktop-Utility zu einer intelligenten Wissensschicht für alle Speicherorte von Dateien wachsen kann.
Schlussfolgerung Die Zielgruppe scheint aus Einzelpersonen oder kleinen Gruppen zu bestehen, die Organisation und Datenschutz schätzen, aber nicht unternehmenszentriert sind. Es gibt jedoch keine Belege für spezifische Kundensegmente oder Personas, die über breite Kategorien hinaus definiert sind.
Business Model & Preisbelege
Es gibt keine Belege in der Beschreibung für ein Geschäftsmodell oder eine Preisstruktur. Der Autor erwähnt keine Monetarisierung, Lizenzierung, Abonnements oder irgendeinen kommerziellen Rahmen.
Schlussfolgerung Das Produkt wird als Einreichung für einen Hackathon beschrieben und nicht als kommerzielles Angebot. Es gibt keine Anzeichen dafür, dass es über den Prototyp oder die persönliche Nutzung hinausgegangen ist.
Technische & Auslieferungs-Signale
Die Beschreibung besagt, dass LifeLibrary mit folgenden Komponenten erstellt wurde:
- Technologien: Electron, Node.js, HTML, CSS, JavaScript
- KI-Modelle: Codex, LM Studio, GPT-5.6 (über eine OpenAI-kompatible API)
- Funktionen: Lokale oder Cloud-KI-Verarbeitung, Dokumentextraktion, semantische Suche, persistente Indizierung, visueller Wissensgraph, Dateisystem-Sicherheit
Es umfasst:
- Kontextisolierte IPC-Brücke
- Begrenzte Dokumentparser
- Strukturierte KI-Ausgabepipeline
- Visueller Kategoriebrowser und Dateiuniversum
- Windows-Installer mit markenbezogener Ikonografie
Schlussfolgerung Der technische Stack deutet auf eine Desktop-Anwendung mit starker Integration von KI und Dateisystemoperationen hin. Es werden jedoch keine Belege für Skalierbarkeit, Leistungskennzahlen oder Produktivbetrieb vorgelegt.
Traction & Reifegrad-Signale
Es gibt keine Belege für Traction, Umsatz, Kunden oder Adoption über die eigene Entwicklung des Autors und die Hackathon-Einreichung hinaus.
Die Beschreibung besagt:
- Teamgröße: 0
- Keine Mitglieder aufgelistet
- Keine Finanzierungsrunden oder Bewertungen
- Keine öffentliche Produktveröffentlichung oder Nutzerbasis
Schlussfolgerung Dies ist ein Prototyp- oder Proof-of-Concept-Projekt, das für einen Hackathon eingereicht wurde. Es hat keinen realen Einsatz oder Markttraktion nachgewiesen.
Wettbewerbskontext
Die Beschreibung liefert keine Informationen über Wettbewerber oder die Wettbewerbslandschaft.
Schlussfolgerung Es gibt keine Belege dafür, wie LifeLibrary im Vergleich zu bestehenden Dateiverwaltungs- oder KI-gestützten Wissenswerkzeugen (z. B. Notion, Roam Research, OneNote oder Dateiscan-Tools) abschneidet. Der Autor verweist weder auf Vorarbeiten noch auf eine Marktpositionierung.
Offene Fragen & Risiken
- Keine Traction oder Nutzerbasis: Das Produkt wird als Hackathon-Einreichung beschrieben, ohne Belege für eine reale Adoption.
- Unbewiesenes Geschäftsmodell: Keine Anzeichen für Monetarisierung oder kommerzielle Tragfähigkeit.
- Begrenzte Teamgröße: Die Teamgröße ist mit 0 angegeben, was darauf hindeutet, dass es kein Entwicklungsteam über den Autor hinaus gibt.
- Nur selbst gemeldet: Alle Aussagen sind unbestätigt und basieren auf der eigenen Beschreibung des Autors.
- Keine öffentliche Verfügbarkeit: Keine Belege für ein herunterladbares Produkt oder eine Live-Demo.
Schlussfolgerung Das Projekt scheint eine experimentelle Idee ohne kommerzielle oder operative Reife zu sein. Es ist ohne weitere Entwicklung und Validierung nicht für Investitions- oder Partnerschaftsüberlegungen geeignet.
Fragen, die die Beschreibung offenlässt
- Wie ist der aktuelle Status des Produkts? Ist es zum Herunterladen oder Testen verfügbar?
- Wie funktioniert die KI-Integration in der Praxis – welche Genauigkeits- und Zuverlässigkeitskennzahlen gibt es?
- Gibt es Pläne zur Monetarisierung dieses Tools, und wenn ja, welches Modell wird in Betracht gezogen?
- Hat das Team den Bedarf an diesem Produkt mit echten Nutzern oder Early Adoptern validiert?
- Welche technischen Einschränkungen bestehen beim Betrieb lokaler KI-Modelle im Vergleich zu cloudbasierten Modellen?
- Wie skaliert das visuelle Dateiuniversum mit größeren Datensätzen?
Gesamtbewertung
Nicht belegt.
Die Beschreibung liefert keine Belege für Umsatz, Kunden, Traction oder ein tragfähiges Geschäftsmodell. Das Produkt wird als Hackathon-Einreichung beschrieben und ist noch kein kommerzielles Angebot.
Schlussfolgerung Auf dieser Stufe ist LifeLibrary ein experimentelles Konzept ohne nachgewiesenes kommerzielles Potenzial. Bevor eine Investition oder Partnerschaft in Betracht gezogen werden kann, wären erhebliche Entwicklungsarbeit, Nutzervalidierung und Markttests erforderlich.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.