

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 1
Platz #1.025 von 7.848 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.585 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 132 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
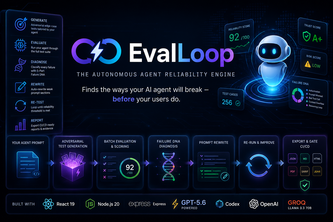
EvalLoop – Autonomous Agent Reliability Engine ist ein selbst gemeldetes Projekt, das von Shital Parab für den OpenAI 2026 Hackathon eingereicht wurde. Die Beschreibung besagt, dass es Codex, GPT-5.6, Groq, OpenAI, React und Vercel verwendet, um adversarial Tests zu generieren, Fehler zu diagnostizieren, Prompts umzuschreiben und die Zuverlässigkeit von KI-Agenten zu verbessern. Es wird als ein Werkzeug präsentiert, um potenzielle Ausfälle in autonomen KI-Agenten zu identifizieren, bevor Nutzer sie erleben.
Das Projekt scheint ein Konzept oder Prototyp in einer frühen Phase zu sein, ohne Hinweise auf Umsatz, Kunden oder Traction. Der Autor beschreibt es als eine Lösung für die Zuverlässigkeit von KI-Agenten, klärt aber nicht, wie es monetarisiert oder implementiert werden soll. Das Einzelmitglied im Team und der Hackathon-Kontext deuten auf einen Proof-of-Concept hin, nicht auf ein ausgereiftes Produkt.
Die wichtigste offene Frage
Was ist der tatsächliche Mechanismus, mit dem EvalLoop adversarial Tests generiert und Fehler diagnostiziert? Die Beschreibung bietet keine technischen Details, sondern nur selbst gemeldete Aussagen zu seiner Funktionalität.
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass EvalLoop ein "Autonomous Agent Reliability Engine" ist, das mit Codex, GPT-5.6, Groq, OpenAI, React und Vercel entwickelt wurde. Es behauptet, adversarial Tests zu generieren, Fehler zu diagnostizieren, Prompts umzuschreiben und die Agenten-Zuverlässigkeit zu steigern.
Schlussfolgerung Basierend auf dem Technologie-Stack und der selbst gemeldeten Funktionalität operiert EvalLoop wahrscheinlich als ein Software-Tool oder eine Plattform, die KI-Modelle (insbesondere GPT-5.6) verwendet, um Fehlerbedingungen in autonomen Agenten zu simulieren und Verbesserungen vorzuschlagen.
Nicht belegt Die tatsächliche Architektur, Benutzeroberfläche oder der operative Mechanismus von EvalLoop wird nicht beschrieben. Der Autor gibt keine Details darüber, wie adversarial Testing implementiert ist oder was im Kontext eines KI-Agenten als "Fehler" gilt.
Positionierung & Claim-Entwicklung
Der Slogan lautet: „EvalLoop findet die Wege, auf denen Ihr KI-Agent brechen wird – bevor es Ihre Nutzer tun.“ Dies positioniert EvalLoop als ein proaktives Zuverlässigkeitstest-Tool für autonome KI-Agenten, mit dem Schwerpunkt auf der frühzeitigen Erkennung und Prävention von Ausfällen.
Behauptung
Der Autor behauptet, dass EvalLoop mit Codex + GPT-5.6 entwickelt wurde und adversarial Tests generieren, Fehler diagnostizieren, Prompts umschreiben und die Agenten-Zuverlässigkeit steigern kann.
Nicht belegt Es gibt keine Hinweise auf eine frühere Positionierung oder Entwicklung der Produktansprüche über diese einzelne selbst gemeldete Beschreibung hinaus. Es wird keine Erwähnung früherer Versionen, Marktrückmeldungen oder iterativer Entwicklung gemacht.
Zielkunde & ICP
Die Beschreibung besagt, dass EvalLoop für Nutzer gedacht ist, die die Zuverlässigkeit von KI-Agenten verbessern und Ausfälle verhindern möchten, bevor sie Endnutzer betreffen.
Schlussfolgerung Die Zielkundschaft umfasst wahrscheinlich Entwickler, KI-Ingenieure oder Produktteams, die an autonomen Agenten oder KI-gestützten Systemen arbeiten. Das Tool richtet sich möglicherweise an diejenigen, die KI-Systeme in Unternehmens- oder Entwicklerkontexten aufbauen oder warten.
Nicht belegt Es werden keine spezifischen Kundensegmente, Personas oder Anwendungsfälle beschrieben. Es gibt keine Hinweise darauf, ob EvalLoop Startups, Unternehmen oder Einzelentwickler anspricht.
Business Model & Preisbelege
Die Beschreibung enthält keine Angaben zu Preisen, Monetarisierung oder Geschäftsmodell.
Nicht belegt Es liegen keine Hinweise auf ein Geschäftsmodell, eine Preisstruktur oder Einnahmequellen vor. Das Projekt scheint eine Idee oder ein Prototyp in einer frühen Phase zu sein, ohne Anzeichen von kommerzieller Tragfähigkeit oder einer Monetarisierungsstrategie.
Technische & Auslieferungs-Signale
Der Autor gibt an, dass EvalLoop mit Codex, GPT-5.6, Groq, OpenAI, React und Vercel entwickelt wurde.
Schlussfolgerung Das Tool integriert wahrscheinlich KI-Modelle (GPT-5.6, Codex) mit einer in React erstellten Frontend-Schicht, die über Vercel gehostet wird. Es könnte Prompt Engineering oder adversarial testing Workflows mit diesen Technologien umfassen.
Nicht belegt Es gibt keine Hinweise auf eine technische Architektur, Datenfluss oder einen Auslieferungsmechanismus über die verwendeten Tools hinaus. Es werden keine Details dazu angegeben, wie adversarial tests generiert oder Fehler diagnostiziert werden.
Traction & Reifegrad-Signale
EvalLoop wurde beim OpenAI 2026 Hackathon eingereicht und hat eine Teamgröße von einer Person (Shital Parab).
Schlussfolgerung Das Projekt befindet sich wahrscheinlich in einer frühen Prototyp- oder Proof-of-Concept-Phase, basierend auf seiner Hackathon-Einreichung und dem Team mit nur einem Mitglied.
Nicht belegt Es gibt keine Hinweise auf Traction, Kundenakzeptanz, Einnahmen oder Produktreife. Es gibt keine Anzeichen für Nutzerfeedback, Nutzungsdaten oder Produktentwicklung über die ursprüngliche Einreichung hinaus.
Wettbewerbskontext
Die Beschreibung erwähnt keine Wettbewerber oder bestehenden Lösungen im Bereich der KI-Agenten-Verlässlichkeit.
Nicht belegt Es wird keine Wettbewerbslandschaft oder Differenzierungsstrategie beschrieben. Der Autor verweist nicht auf ähnliche Tools oder Plattformen, die möglicherweise dasselbe Problem lösen.
Offene Fragen & Risiken
- Unklarer Mechanismus: Die Beschreibung enthält keine technischen Details dazu, wie adversarial testing oder Fehlerdiagnose implementiert werden.
- Prototyp in einer frühen Phase: Eingereicht bei einem Hackathon mit einem Teammitglied, was auf begrenzte Entwicklung oder kommerzielle Reife hindeutet.
- Ungeprüfte Behauptungen: Alle Funktionen werden selbst gemeldet, ohne Belege für Leistung oder Ergebnisse.
- Keine Monetarisierungsstrategie: Es gibt keine Hinweise darauf, wie EvalLoop Einnahmen generieren oder im großen Maßstab deployed werden könnte.
Fragen, die die Beschreibung offenlässt
- Welche spezifischen adversarial testing Methoden verwendet EvalLoop, und wie werden Fehler diagnostiziert?
- Wie integriert sich EvalLoop in bestehende KI-Agenten-Frameworks oder Plattformen?
- Steht ein Prototyp oder eine Demo zur Prüfung zur Verfügung?
- Was ist das beabsichtigte Deployment-Modell (SaaS, API, On-Premises)?
- Wie handhabt EvalLoop das Prompt Rewriting und wie hoch ist die Genauigkeit dabei?
Gesamtbewertung
EvalLoop wird als Idee oder Hackathon-Projekt in einer frühen Phase präsentiert, ohne nachgewiesene Traction, Einnahmen oder Kundenbasis. Die Beschreibung mangelt an technischer Tiefe, Klarheit des Geschäftsmodells oder Belegen für Product-Market-Fit.
Bewertung Zu diesem Zeitpunkt nicht bereit für Investitions- oder Partnerschaftsüberlegungen. Es sind erhebliche Entwicklungs- und Validierungsmaßnahmen erforderlich, um über einen Prototyp hinauszugehen.
Vertrauensgrad Niedrig – basiert ausschließlich auf dünnen, selbst gemeldeten Belegen.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung und den dort gegebenenfalls angegebenen Built-with-Tags, da der Autor keinen Projektbericht veröffentlicht hat — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.