

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #3.400 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Wofür das Unternehmen offenbar steht
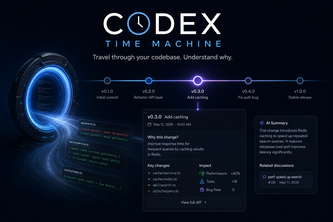
Codex Time Machine ist ein selbst gemeldetes Tool, das darauf ausgelegt ist, kontrollierte kontrafaktische Experimente in der KI-gestützten Softwareentwicklung zu ermöglichen. Es erlaubt es Benutzern, den Entscheidungsprozess eines KI-Agenten aus einem historischen Snapshot heraus zu replizieren, minimale, nicht preisgebende Hinweise darauf zu injizieren, welche Untersuchung übersehen wurde, und zu messen, ob diese Intervention zu anderen, aber beobachtbaren Ergebnissen führt.
Was sich geändert hat
Die Projektbeschreibung stellt einen neuen Ansatz zur Bewertung von KI-Coding-Agenten vor, der sich auf target coverage konzentriert, anstatt auf Korrektheit oder Aktivitätsvolumen. Es führt das Konzept eines „Ghost Engineer clue“ ein – ein minimaler Hinweis, der nur aufzeigt, was nicht untersucht wurde, nicht aber die Antwort selbst.
Wichtigste offene Frage
Gibt es Belege dafür, dass dieses System in der Produktion eingesetzt oder in echte Engineering-Workflows integriert wurde? Die Beschreibung ist vollständig selbst gemeldet und enthält keine Daten zu Adoption, Nutzung oder Wirkung über eine Demo hinaus.
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass Codex Time Machine eine neunphasige temporale Evidenz-Pipeline zur Replikation von KI-Engineering-Entscheidungen ist. Es funktioniert durch:
- Einfrieren eines ursprünglichen historischen Laufs.
- Versiegeln späterer Evidenz hinter einer temporalen Grenze.
- Identifizieren der Untersuchung, die der Agent verpasst hat.
- Generieren eines minimalen „Ghost Engineer clue“.
- Replizieren der Aufgabe aus demselben Start-Snapshot.
- Vergleichen von Baseline- und Replay-Verläufen, um die target-spezifische Abdeckung zu messen.
Es ist in Python (mit Pydantic, Pytest) für das Backend und React/TypeScript/Vite für das Frontend implementiert. Das System veröffentlicht deterministische JSON- und Markdown-Artefakte mit SHA-256-Manifesten.
Schlussfolgerung Dies scheint ein Proof-of-Concept- oder Hackathon-Projekt zu sein, das sich auf KI-Auditing und Reproduzierbarkeit in Softwareentwicklungskontexten konzentriert.
Positionierung & Claim-Entwicklung
Der Autor behauptet, dass Codex Time Machine KI-Engineering-Entscheidungen falsifizierbar, auditierbar und reproduzierbar macht und eine Lücke in aktuellen Tools adressiert: „Keines dieser Tools beantwortet eine tiefere Frage: Wurde das Ergebnis durch eine schlechte Implementierung verursacht, oder hat der Agent es einfach versäumt, das Richtige zu untersuchen?“
Es führt ein neues Evaluierungsparadigma ein, in dem:
- Der Fokus auf target coverage liegt, anstatt auf Korrektheit.
- Das System vermeidet, Antworten oder Chain-of-Thought preiszugeben.
- Es trennt total activity von investigation quality.
Das Projekt positioniert sich als Tool für kontrolliertes kontrafaktisches Reasoning und zielt darauf ab, KI-Agenten-Entscheidungen transparenter und testbarer zu machen.
Schlussfolgerung Dies ist ein konzeptioneller Rahmen zur Bewertung von KI-Agenten in Engineering-Workflows, noch kein kommerzielles Produkt. Die Behauptungen sind aspirativ und selbst gemeldet.
Zielkunde & ICP
Die Beschreibung nennt keine spezifischen Kunden oder Personas. Sie impliziert jedoch Anwendungsfälle im Bereich:
- KI-Engineering-Teams, die Agentenverhalten bewerten.
- Software-Engineers, die KI-gestützte Entscheidungen auditieren möchten.
- CI/CD-Pipelines oder Pull-Request-Integrationen (erwähnt in „What’s next“).
- Engineering-Entscheidungs-Auditoren oder Forscher.
Es ist nicht klar, ob das Tool Einzelentwickler, Teams oder Unternehmen anspricht.
Schlussfolgerung Die ICP scheinen technische Nutzer oder Engineering-Teams zu sein, die mit AI Agents arbeiten, jedoch wird keine explizite Segmentierung oder Zielgruppenansprache angegeben.
Business Model & Preisbelege
In der Beschreibung gibt es keine Hinweise auf ein Geschäftsmodell oder eine Preisstruktur. Das Projekt wird als Demo und als Hackathon-Einreichung präsentiert.
Schlussfolgerung Aus den selbstberichteten Inhalten ist keine Strategie zur Kommerzialisierung oder Monetarisierung ersichtlich.
Technische & Auslieferungs-Signale
Das System wurde mit folgenden Komponenten erstellt:
- Backend: Python, Pydantic, Pytest
- Frontend: React, TypeScript, Vite
- Tools: Docker, Git, OpenAI Codex, GPT-5.6 (verwendet über Codex)
- Architektur: Neunphasige Pipeline mit Integritätsprüfungen und deterministischen Ausgaben
Es umfasst:
- SHA-256-Manifeste
- Kanonisches Hashing
- Validierung der Quellherkunft
- Unveränderliche Phasennachweise
- Fail-closed-Integritätsprüfungen
- Über 500 Backend-Tests, 19 Frontend-Tests
Die Demo ist eine statische öffentliche Anwendung, für die kein API-Schlüssel oder Live-Modell erforderlich ist.
Schlussfolgerung Die technische Architektur ist für einen Proof-of-Concept robust, weist jedoch keine Hinweise auf Skalierbarkeit oder Produktivbetrieb auf.
Traction & Reifegrad-Signale
Es gibt keine Hinweise auf Traction, einschließlich:
- Kein Umsatz
- Keine Kunden
- Keine Nutzungsdaten
- Keine Produktadoption über die Demo hinaus
Das Projekt wird als Hackathon-Einreichung und öffentliche Demo beschrieben, ohne Hinweise auf eine Anwendung in der Praxis oder Integration.
Schlussfolgerung Dies ist ein Konzept in einer frühen Phase, das wahrscheinlich noch nicht im Produktivbetrieb ist oder von Nutzern verwendet wird.
Wettbewerbskontext
Die Beschreibung erwähnt keine Wettbewerber. Sie impliziert, dass aktuelle Tools zur Bewertung von AI Agents die Frage nicht adressieren, was bei der Untersuchung übersehen wurde – nur, ob das Endergebnis korrekt war.
Es positioniert sich als neuartiger Ansatz für AI Auditing und Gegenfaktisches Schließen, es wird jedoch kein Vergleich mit bestehenden Tools vorgenommen.
Schlussfolgerung In der Beschreibung ist keine Wettbewerbslandschaft oder Differenzierung von anderen AI-Engineering-Tools ersichtlich.
Offene Fragen & Risiken
- Keine Nutzung oder Adoption in der Praxis: Das System wird nur als Demo beschrieben, nicht als Produkt.
- Unbewiesene Nützlichkeit: Der Mehrwertvorschlag ist konzeptionell und in der Praxis nicht getestet.
- Begrenzter Umfang: Die Demo konzentriert sich auf einen spezifischen Anwendungsfall (LegalRAG-Retrieve) ohne Hinweise auf Verallgemeinerbarkeit.
- Nur selbstberichtet: Keine unabhängige Verifizierung oder Validierung durch Dritte.
- Kein Weg zur Monetarisierung: Keine Hinweise auf ein Geschäftsmodell oder eine Roadmap zur kommerziellen Tragfähigkeit.
Schlussfolgerung Das Projekt ist eine konzeptionelle Innovation, kein für den Markt oder die Investition bereitstehendes Produkt.
Fragen, die die Beschreibung offenlässt
- Wurde dieses System in irgendeinem realen Engineering-Workflow oder in CI/CD-Pipelines verwendet?
- Was sind die tatsächlichen Einschränkungen bei der Anwendung auf größere, komplexere AI-Agent-Systeme?
- Gibt es Pläne zur Integration mit bestehenden Entwicklungstools (z. B. GitHub, GitLab)?
- Wie lässt sich dieser Ansatz über eine einzelne Demo hinaus skalieren?
- Wie lautet die geplante Roadmap für den Produktivbetrieb oder die Kommerzialisierung?
Gesamtbewertung
Nicht nachgewiesen.
Die Beschreibung präsentiert eine konzeptionelle Innovation im Bereich des AI-Agent-Auditing und der Reproduzierbarkeit, weist jedoch keine Hinweise auf Traction, Umsatz, Kunden oder Product-Market-Fit auf.
Es ist nicht klar, ob sich dieses Projekt zu einem Produkt entwickelt hat oder ob es lediglich eine Idee oder ein Prototyp ist.
Konfidenz: Niedrig.
Dies ist eine selbstberichtete Hackathon-Einreichung ohne unabhängige Verifizierung oder Beleg für eine Kommerzialisierung. Es handelt sich möglicherweise um ein vielversprechendes Konzept für eine zukünftige Entwicklung, erfüllt jedoch auf Basis der vorliegenden Informationen noch nicht die Kriterien für eine Investitions- oder Partnerschaftsbetrachtung.
Umsetzen
Möchtest du etwas Ähnliches wie Codex Time Machine bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Codex Time Machine oder seinen Autoren verbunden.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.