

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #3.360 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Wofür das Unternehmen offenbar steht
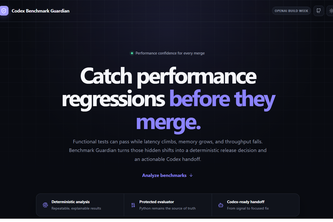
Codex Benchmark Guardian ist ein Entwicklerwerkzeug, das Leistungsrückgänge in Codeänderungen erkennt, begrenzte Reparaturziele für KI-Agenten (Codex) erstellt und Korrekturen vor dem Merge über geschützte Prüfungen verifiziert. Es ist als eigenständiges System mit einem Dashboard, einer CLI, einer API und einer GitHub-Integration aufgebaut.
Was sich geändert hat
Der Autor gibt an, dieses Werkzeug entwickelt zu haben, um eine Lücke in CI/CD-Workflows zu schließen, in der Funktionstests bestehen, die Leistung jedoch stillschweigend nachlässt. Das Projekt führt eine "verified Codex Repair Loop" ein, die sicherstellt, dass KI-Agenten Rückgänge untersuchen und beheben können, ohne die Benchmark-Richtlinie zu steuern oder Code selbst zu mergen.
Wichtigste offene Frage
Gibt es Belege für eine Nutzung in der Praxis, eine Verbreitung oder eine Traction über die eigene Entwicklung und das eigene Testen des Autors hinaus?
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass Codex Benchmark Guardian ein Entwicklerwerkzeug ist, das entwickelt wurde, um Leistungsrückgänge in Softwareänderungen zu erkennen. Es vergleicht Basis- und aktuelle Benchmarkdaten über Metriken wie Latenz, Laufzeit, Speichernutzung, Fehlerrate, Durchsatz, Genauigkeit, Recall und Erfolgsquote.
Es unterstützt sowohl Metriken, bei denen höhere Werte schlechter sind, als auch solche, bei denen niedrigere Werte schlechter sind, und erzeugt Ausgaben, einschließlich:
- prozentualen Änderungen;
- Entscheidungen zu Regressionen;
- Klassifizierungen der Schweregrade;
- Bewertungen der Release-Bereitschaft;
- Leitlinien zur Triage;
- Markdown- und HTML-Berichten;
- Übergaben an GitHub-Issues;
- begrenzten Codex-Reparaturzielen;
- unveränderlichen Repair Contracts;
- CI- und Pull-Request-Guardrail-Artefakten.
Das System umfasst ein Produktions-Dashboard, das mit Next.js, FastAPI und Python erstellt wurde; eine Kommandozeilenoberfläche, die Typer verwendet; und eine Streamlit-Oberfläche. Es integriert sich auch in GitHub Actions für geschützte Pull-Request-Benchmark-Gates.
Evidenz
- Der Autor beschreibt die Funktionalität des Werkzeugs im Detail.
- Es unterstützt mehrere Metriktypen und Ausgabeformate.
- Es enthält Integrationspunkte wie GitHub Actions, FastAPI-Endpunkte und CLI-Tools.
Schlussfolgerung Das Produkt scheint ein Workflow-Automatisierungssystem zu sein, das Leistungstests und KI-gestützte Code-Reparatur innerhalb von CI/CD-Pipelines verbindet.
Positionierung & Claim-Entwicklung
Der Autor positioniert Codex Benchmark Guardian als Lösung für die Erkennung von Leistungsrückgängen in Softwareentwicklungs-Workflows. Die zentrale Behauptung ist, dass es die Lücke zwischen Benchmark-Warnungen und handhabbarer Triage schließt, indem es sichere, begrenzte KI-Reparaturprozesse ermöglicht.
Es betont:
- dass Funktionstests bestehen können, während die Leistung nachlässt;
- dass viele bestehende Werkzeuge bei der Warnung enden, ohne Entwickler zur Behebung von Problemen zu leiten;
- dass KI-Agenten zur Untersuchung und Reparatur zugelassen werden sollten, aber nicht ihre eigene Arbeit steuern oder genehmigen dürfen;
- dass das System eine "verified Codex Repair Loop" durchsetzt, die eine Selbstevaluierung der Reparaturergebnisse verhindert.
Evidenz
- Der Autor stellt diese Behauptungen ausdrücklich auf.
- Das Projekt wird als Lösung für ein spezifisches Problem in CI/CD-Workflows präsentiert.
Schlussfolgerung Die Positionierung spiegelt einen Versuch wider, sich von generischen Benchmarking-Tools abzuheben, indem KI-Sicherheit und begrenzte Reparaturlogik in den Prozess eingeführt werden.
Zielkunde & ICP
Die Beschreibung zeigt, dass Codex Benchmark Guardian an Entwickler in Software-Engineering-Umgebungen gerichtet ist, in denen Leistung eine Rolle spielt, insbesondere an solche, die CI/CD-Pipelines mit GitHub Actions oder ähnlichen Plattformen nutzen.
Es ist für den Einsatz in folgenden Bereichen positioniert:
- Code-Review-Workflows;
- Leistungskritische Anwendungen;
- Teams, die Benchmarking-Tools und KI-Agenten (z. B. Codex) in Entwicklungsprozessen einsetzen.
Evidenz
- Das Tool unterstützt GitHub-Integration und CI/CD-Umgebungen.
- Es enthält Schnittstellen für Entwickler, um Belege zu prüfen, Regressionsprobleme zu triagieren und Reparaturaufgaben zu generieren.
Schlussfolgerung Die ICP umfasst wahrscheinlich Engineering-Teams oder Einzelpersonen, die sich für Leistungsqualität interessieren und die Erkennung und Reparatur von Regressionsproblemen mithilfe von KI-Tools automatisieren oder halbautomatisieren möchten.
Business Model & Preisbelege
In der bereitgestellten Beschreibung gibt es keine Erwähnung von Preisen, Monetarisierungsstrategie oder Geschäftsmodell.
Evidenz
- Es werden keine Umsatzquellen, Abonnements, Lizenzmodelle oder Preistufen beschrieben.
- Das Projekt wird als eigenständiges Tool für den persönlichen oder internen Gebrauch präsentiert.
Schlussfolgerung Es scheint sich um ein Open-Source- oder Prototyp-Tool zu handeln, das in dieser Phase keinen klaren Weg zur Kommerzialisierung aufweist.
Technische & Auslieferungs-Signale
Der Autor berichtet, dass das System Folgendes verwendet:
- Python 3.12 für die Backend-Analyse;
- Typer für die CLI;
- FastAPI für die API;
- Next.js 15, TypeScript, Tailwind CSS für das Dashboard;
- Streamlit für die lokale Oberfläche;
- Pytest für Tests;
- Ruff für Linting;
- GitHub Actions und Docker für geschützte Auswertungen;
- Deterministische Generierung von Berichten (Markdown, HTML, JSON, YAML).
Es umfasst:
- 162 automatisierte Python-Tests;
- Frontend-Linting, TypeScript-Prüfungen, Build-Validierung;
- Geschütztes Benchmark-Gate mit eingeschränkten Containern und Runnern;
- Unterstützung für moderne Desktop- und Mobile-Browser.
Evidenz
- Der Autor listet die verwendeten Technologien auf.
- Es werden Details zu Test-, Linting- und Deployment-Praktiken angegeben.
Schlussfolgerung Das Tool wird mit einem Fokus auf Reproduzierbarkeit, Sicherheit (über geschützte Workflows) und Entwicklererfahrung (CLI, Dashboard, GitHub-Integration) entwickelt.
Traction & Reifegrad-Signale
Es gibt keine Hinweise auf Traction oder Adoption über die eigene Entwicklung und Testung des Autors hinaus. Das Projekt wurde für einen Hackathon eingereicht und scheint keine Kunden, Nutzer oder Einnahmen zu haben.
Evidenz
- Es werden keine Kundennamen, Logos, Testimonials oder Nutzungsdaten bereitgestellt.
- Es gibt keine Erwähnung von Product-Market-Fit oder einer realen Implementierung.
- Die einzige Demonstration ist ein einzelner validierter Pull Request aus dem eigenen Repository des Autors.
Schlussfolgerung Das Projekt scheint sich in einer frühen Entwicklungsphase oder in Form eines Prototyps zu befinden, ohne messbare Traction.
Wettbewerbskontext
Es werden keine direkten Wettbewerber genannt, aber die Beschreibung deutet darauf hin, dass bestehende Benchmarking-Tools in Bezug auf die Anleitung von Entwicklern durch Triage- und Reparatur-Workflows unzureichend sind. Das Tool führt ein neues Konzept ein: einen „verified Codex Repair Loop“, der verhindert, dass KI-Agenten Guardrails während der Reparatur schwächen.
Evidenz
- Der Autor stellt seinen Ansatz generischen Benchmarking-Tools gegenüber.
- Sie betonen die Notwendigkeit von begrenzten, geschützten Reparatur-Workflows.
Schlussfolgerung Der Wettbewerbsraum umfasst wahrscheinlich CI/CD-Plattformen, Performance-Monitoring-Tools und AI-Agent-Frameworks. In der Beschreibung werden jedoch keine konkreten Wettbewerber identifiziert.
Offene Fragen & Risiken
- Keine kommerzielle Traction oder Adoption: Das Tool wird ausschließlich als Hackathon-Einreichung beschrieben, ohne Belege für eine Nutzung in der Praxis.
- Unbewiesene AI-Sicherheitsgrenzen: Obwohl das System behauptet, strenge Grenzen für das Verhalten von Codex durchzusetzen, gibt es keine unabhängige Validierung dieser Kontrollen.
- Ein-Personen-Team: Da nur ein Mitglied aufgeführt ist, sind Skalierbarkeit und langfristige Wartung problematisch.
- Selbstberichtete Leistungsdaten: Die Demonstration verwendet einen einzelnen Pull Request; es werden keine breiteren Datensätze oder externe Validierungen bereitgestellt.
- Unklare Monetarisierungsstrategie: Es gibt keine Hinweise darauf, wie das Tool verkauft oder kommerziell genutzt werden könnte.
Evidenz
- Alle Risiken resultieren aus dem Mangel an Belegen in der Beschreibung.
Schlussfolgerung Dies ist ein hochriskantes Projekt in einer frühen Phase mit begrenzter kommerzieller Tragfähigkeit, es sei denn, es wird weiter validiert und entwickelt.
Fragen, die die Beschreibung offenlässt
- Welche spezifischen Leistungsprobleme haben Sie in Ihrem eigenen Entwicklungsworkflow beobachtet, die zur Entwicklung dieses Tools geführt haben?
- Wie planen Sie, über den Anwendungsfall eines einzelnen Entwicklers hinauszuskalieren?
- Haben Sie das System mit anderen Teams oder Repositories außerhalb der eigenen getestet?
- Können Sie weitere Details dazu liefern, wie die „geschützte“ Auswertung in der Praxis funktioniert? Ist sie tatsächlich von nicht vertrauenswürdigen Code isoliert?
- Welche sind die zentralen Annahmen über das Verhalten von Codex, die das Systemdesign untermauern?
- Gibt es bekannte Grenzfälle oder Fehlermodi in der aktuellen Implementierung?
- Wie beabsichtigen Sie, dieses Tool zu monetarisieren oder zu kommerzialisieren?
- Wie lautet Ihre Roadmap für die zukünftige Entwicklung und die Ergänzung von Funktionen?
Gesamtbewertung
nicht belegt
Es liegen unzureichende Belege vor, um zu beurteilen, ob Codex Benchmark Guardian Investitionspotenzial hat oder für eine Partnerschaft geeignet wäre. Das Projekt scheint ein Prototyp oder eine Hackathon-Einreichung zu sein, ohne nachgewiesene Traction, Einnahmen oder Kundenbasis.
Die Behauptungen des Autors zu AI-Sicherheit und begrenzter Reparatur sind überzeugend, aber ohne unabhängige Tests oder Daten aus dem produktiven Betrieb nicht verifiziert.
Vertrauensgrad Niedrig
Begründung
Die Beschreibung ist vollständig selbstberichtet und enthält keine externe Validierung, Metriken oder Nutzerfeedback. Sie gibt nicht an, ob das Tool von anderen übernommen oder in Produktivumgebungen getestet wurde.
Umsetzen
Möchtest du etwas Ähnliches wie Codex Benchmark Guardian bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Codex Benchmark Guardian oder seinen Autoren verbunden.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.