

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #3.072 von 7.848 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.585 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 132 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Wofür das Unternehmen offenbar steht
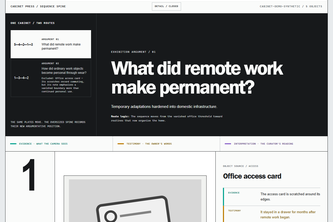
Cabinet Press ist ein selbst gemeldetes Werkzeug für den Bildungsbereich, das es Lernenden ermöglicht, fünf Objekte zu fotografieren, Notizen hinzuzufügen und aus diesen Eingaben zwei kontrastierende Ausstellungen zu generieren. Das System behauptet, die Quellenzuordnung für alle in jeder Ausstellung aufgestellten Behauptungen aufrechtzuerhalten.
Was sich geändert hat
Der Autor gibt an, dass er dies als Reaktion auf die Tendenz von KI entwickelt hat, verschiedene Arten von Informationen (Beobachtung, Zeugenaussage, Interpretation) ohne klare Unterscheidung zu vermischen – insbesondere in Lernkontexten, in denen solche Unterscheidungen pädagogisch wichtig sind.
Wichtigste offene Frage
Erfüllt Cabinet Press tatsächlich seine Behauptung, dass es beobachtbare Belege zuverlässig von Quellenzeugen und kuratorischer Interpretation trennen kann, oder erlaubt das System weiterhin eine semantische Vermischung, die seinen Bildungszweck untergräbt?
Analysegrundlage
Dieser Bericht basiert ausschließlich auf der vom Autor bereitgestellten, selbst gemeldeten Projektdescription. Er enthält keine externe Verifizierung, keine Umsatzdaten, keine Kundinformationen und keine Traction-Metriken.
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass Cabinet Press:
- Fünf von einem Nutzer fotografierte Objekte akzeptiert
- Kurze Notizen zu jedem Objekt aufnimmt
- Zwei kontrastierende Ausstellungen aus diesen Eingaben erzeugt
- Behauptungen in drei Kategorien einteilt:
- Beobachtbare Belege (basierend auf den gelieferten Fotografien)
- Quellenzeugen (exakte Zitate oder Paraphrasen, die mit dem Notizbereich verknüpft sind)
- Kuratorische Interpretation (muss Quellen zitieren und die Begründung zeigen)
- Verwendet eine Sequence Spine zur Anordnung der Objekte, wobei die Änderung der kuratorischen Fragestellung alles neu sortiert
- Rendert die Ausgabe als statisches HTML, das offline funktioniert und druckfertige A5-Accessionskarten enthält
- Wird lokal mit Node.js betrieben, ohne externe Abhängigkeiten
Schlussfolgerung Das Produkt wird als lokales Werkzeug für den Bildungsbereich beschrieben, nicht für kommerzielle oder Enterprise-Implementierungen.
Positionierung & Claim-Entwicklung
Der Autor gibt an:
- KI kann polierte Museumsetiketten schreiben, während sie Beobachtung, Zeugenaussage und Interpretation vermischt
- Diese Vermischung ist in Lernkontexten problematisch, in denen die Unterscheidung entscheidend ist
- Cabinet Press zielt darauf ab, dies zu verhindern, indem es Behauptungen nachvollziehbar auf ihre Quelle zurückführt
Behauptung
Das Produkt positioniert sich als Lösung für das Problem der semantischen Verwirrung in KI-generierten Bildungsinhalten.
Schlussfolgerung Die Positionierung impliziert einen bildungs- oder pädagogischen Fokus, nicht ein KI-Werkzeug für den allgemeinen Gebrauch.
Zielkunde & ICP
Die Beschreibung besagt:
- Der beabsichtigte Nutzer ist ein "Lernender"
- Das System unterstützt "Lernkontexte"
- Es ist so konzipiert, dass es Nutzern hilft zu verstehen, wie aus identischen Quellen unterschiedliche Interpretationen abgeleitet werden können
Nicht belegt Es wird kein spezifischer Kundensegment oder Persona jenseits von "Lernender" beschrieben.
Business Model & Preisbelege
Die Beschreibung besagt:
- Das Werkzeug ist für den Bildungsbereich konzipiert
- Es generiert statische HTML-Ausgaben
- Es verwendet Open-Source-Technologien wie Node.js, TypeScript, Playwright, Vitest usw.
- Es gibt keine Erwähnung von Preisen, Monetarisierung oder einem Geschäftsmodell
Nicht belegt Es gibt keine Hinweise auf ein Geschäftsmodell oder eine Preisstruktur.
Technische & Auslieferungs-Signale
Die Beschreibung besagt:
- Entwickelt mit: CSS, GPT-5.6, HTML, JavaScript, JSON Schema, Node.js, OpenAI Codex, Playwright, TypeScript, Vitest
- Verwendet einen deterministischen Verifier (TypeScript), um die Schema-Struktur, die Existenz von Quellen, die Grenzen der Locator, Übereinstimmungen von Zitaten, Anforderungen an die Begründung und die Unterscheidbarkeit von Argumenten zu prüfen
- Codex wurde für das Domänenmodell, die Definition von Validierungsgrenzen, das Prototyping visueller Richtungen, Barrierefreiheitstests und die Erstellung des Handoffs verwendet
- Die Ausgabe ist statisches HTML ohne Abhängigkeiten mit Offline-Fähigkeit
- Enthält druckfertige A5-Accessionskarten
Schlussfolgerung Das System verwendet einen hybriden Ansatz, der KI zur Inhaltsgenerierung und deterministischen Code zur Verifizierung kombiniert.
Traction & Reifegrad-Signale
Die Beschreibung lautet:
- Eingereicht beim OpenAI 2026 Hackathon auf Devpost
- Teamgröße: 1 Person (Ayush Raj)
- Keine Erwähnung von Umsatz, Kunden oder Adoption
- Das öffentliche Repository enthält nur fiktives Quellmaterial und eine synthetische Ausstellung
- Echte Daten befinden sich in einem privaten Repository
Nicht belegt Keine Hinweise auf Traction, Nutzung oder Marktvalidierung.
Wettbewerbskontext
Die Beschreibung lautet:
- Keine direkten Wettbewerber erwähnt
- Der Fokus liegt auf bildungsbezogenen Anwendungsfällen, in denen KI Informationen ohne klare Zuschreibung vermischt
- Das Tool zielt darauf ab, Reproduzierbarkeit und Quellklarheit zu bieten
Nicht belegt Es wird keine Wettbewerbslandschaft oder ein Vergleich mit bestehenden Tools angegeben.
Offene Fragen & Risiken
Die Beschreibung lautet:
- Der schwierigste Teil war es, eine ehrliche Grenze zwischen semantischer Beurteilung und deterministischer Validierung zu ziehen
- Code kann beweisen, dass ein Zitat mit einem Quellspan übereinstimmt, aber nicht, was ein Foto bedeutet
- Echte Daten werden privat gehalten, was die externe Überprüfbarkeit einschränkt
- Eine zweite Herausforderung bestand darin, den echten Fünf-Objekt-Schrank privat zu halten, den Juroren aber dennoch einen vollständigen Testpfad zu bieten
Offene Frage
Die Abhängigkeit des Systems von KI für kuratorische Urteile in Kombination mit deterministischen Prüfungen wirft Fragen auf, ob die semantischen Grenzen tatsächlich durchgesetzt werden.
Fragen, die die Beschreibung offenlässt
- Wie stellt das Tool sicher, dass die Unterscheidung zwischen "beobachtbaren Belegen" und "kuratorischer Interpretation" über verschiedene Eingaben hinweg aufrechterhalten wird?
- Welche Mechanismen existieren, um zu validieren, dass die von der KI generierten kuratorischen Fragen tatsächlich unterschiedlich sind und nicht nur umformulierte Versionen voneinander?
- Können Sie demonstrieren, wie der deterministische Verifier Fehler in der semantischen Verankerung erkennt, die das Modell möglicherweise übersehen hat?
- Wie würden Sie Fälle handhaben, in denen ein Benutzer mehrdeutige oder widersprüchliche Notizen bereitstellt?
- Was ist der erwartete Workflow für Pädagogen, die dieses Tool im Unterricht einsetzen?
Gesamtbewertung
Die Beschreibung lautet:
- Das Projekt ist eine Hackathon-Einreichung
- Keine Daten zu Umsatz, Kunden oder Traction verfügbar
- Der Autor beabsichtigt, den Authoring-Handoff als installierbare Codex-Funktion zu verpacken
- Zukünftige Schritte umfassen die Bereitstellung von Prüfkontrollen für Lernende über vorgeschlagene kuratorische Fragen
Nicht belegt Aus dieser Beschreibung allein kann keine kommerzielle Machbarkeit, Skalierbarkeit oder Investitionspotenzial ermittelt werden.
Vertrauensgrad Niedrig. Dies ist ein selbstberichteter Bildungsprototyp ohne Hinweise auf Traction, Umsatz oder Marktvalidierung.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.