Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 2
Platz #354 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
 top-founders.comThis project's analysis was made with it
Check your idea against real competitors
Paste your competitors' URLs and get what to match, where to stand out and what to skip, with every claim linked to its source. Free, no credit card.
Trigger reports from Slack or MCP server.
Das Projekt auf Devpost anzeigen
Executive Summary
Wofür das Unternehmen offenbar steht
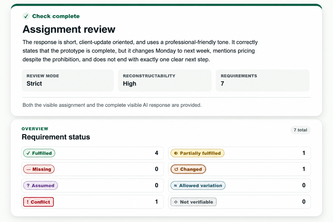
Judgment Boundary ist ein selbstberichtetes Tool, das KI-generierte Antworten anhand zugewiesener Aufgaben unter Verwendung strukturierter Ausgaben von OpenAI-Modellen vergleicht. Der Autor gibt an, dass es Anforderungen rekonstruiert, Ergebnisse anhand deterministischer Regeln prüft und maschinell überprüfbare Urteile von solchen trennt, die einer menschlichen Überprüfung unterliegen.
Was sich geändert hat
Das Projekt entwickelte sich von einer ersten Version, die sichtbare Aufgabenstellung und Antwort verglich, zu einer, die eine "Claim Boundary"-Ebene einführt – dabei bleiben die ursprünglichen Modellergebnisse intakt, während separate Prüfungen für direkte Überprüfbarkeit, manuelle Überprüfung und effektive Ergebnisse angewendet werden. Es unterscheidet nun zwischen den Zuständen Raw (Modell), Machine (direkte Prüfungen), Human (manuelle Überprüfung) und Effective (endgültiges Ergebnis).
Wichtigste offene Frage
Funktioniert das selbstberichtete Produkt des Autors tatsächlich wie beschrieben? Die Beschreibung enthält keine Belege für den Einsatz in der Praxis, Einnahmen, Kunden oder Verbreitung – nur Behauptungen darüber, wie es theoretisch funktioniert.
Hinweis: Diese Analyse basiert ausschließlich auf der vom Anrufer bereitgestellten, selbstberichteten Projektdescription. Es sind keine externen Verifizierungen, historischen Daten oder Quellen Dritter verfügbar. Alle Aussagen sind als Behauptungen des Autors zu betrachten und nicht als Tatsachen, die auf unabhängige Weise festgestellt wurden.
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass Judgment Boundary:
- Eine Aufgabe mit einer KI-Antwort vergleicht
- Sichtbare Anforderungen rekonstruiert und diese anhand der Antwort prüft
- Jeden Befund als erfüllt, geändert, fehlend, angenommen oder widersprüchlich einordnet
- Nicht angeforderte Zusätze markiert
- Befunde mit exakten Auszügen aus der Antwort verknüpft
- Direkte Prüfungen für registrierte Regeln (Wortlimits, exakte Phrasen, Daten usw.) anwendet
- Eine vierschichtige Schnittstelle verwendet: Raw, Machine, Human, Effective
- Ermöglicht die manuelle Lösung ungelöster Elemente mit „Accept with limits“
- Exportiert den Überprüfungsstatus als Markdown-Bericht
Es wird auch angegeben, dass:
- Die App auf Next.js und TypeScript läuft
- OpenAI-Modelle die erste Stufe der Überprüfung übernehmen, indem sie Anforderungen rekonstruieren und strukturierte Kandidaten zurückgeben
- Eine zweite Ebene bewertet Befunde direkt, indem sie deterministische Regeln anwendet oder an eine manuelle Überprüfung weiterleitet
- Manuelle Überprüfungen verwenden signierte, zustandslose Tokens
- Ergebnisse werden nicht in einer Datenbank gespeichert, können aber als Markdown heruntergeladen werden
Schlussfolgerung: Das Produkt scheint ein webbasiertes Tool zur Prüfung von KI-Ausgaben anhand eines strukturierten, mehrschichtigen Ansatzes zu sein. Es ist mit einem modernen Frontend-Stack (Next.js, React) gebaut und integriert OpenAI-APIs.
Positionierung & Claim-Entwicklung
Der Autor gibt an:
- Mit der engen Fragestellung begonnen zu haben: "Hat die Antwort tatsächlich der Aufgabe entsprochen?"
- Sich weiterentwickelt, um tiefere Probleme anzugehen: selbst gut strukturierte Ausgaben können falsch sein
- Eine „Claim Boundary"-Ebene eingeführt, die das Modellurteil von der Verifizierung trennt
- Fail-closed-Verhalten betont – zurückgehaltene Befunde bleiben sichtbar, anstatt stillschweigend aufgelöst zu werden
Die Positionierung hat sich verschoben von:
- Ursprüngliche Idee: Prüfung, ob KI-Antworten den Aufgaben entsprechen
- Entwicklung: Erkenntnis, dass strukturierte Ausgabe keine Korrektheit garantiert
- Aktuelle Form: Trennung des rohen Modellergebnisses von maschinellen Prüfungen, menschlicher Überprüfung und dem endgültigen effektiven Ergebnis
Schlussfolgerung: Die Entwicklung spiegelt ein wachsendes Bewusstsein für die Grenzen des Vertrauens und der Struktur von KI wider – von einem einfachen Konformitätsprüfer hin zu einem Framework für das Management von Unsicherheit in KI-generierten Inhalten.
Zielkunde & ICP
Die Beschreibung benennt keine Zielkunden explizit oder definiert ein ideales Kundenprofil (ICP). Es wird jedoch Folgendes impliziert:
- Nutzer, die KI-Antworten generieren oder bewerten
- Prüfer oder Redakteure, die mit KI-gestützten Ausgaben arbeiten
- Entwickler oder Forscher, die KI-Modelle auf Genauigkeit und Einhaltung von Anweisungen testen
nicht belegt: Es werden keine spezifischen Kundensegmente, Personas, Anwendungsfälle oder Käuferprofile erwähnt.
Business Model & Preisbelege
Die Beschreibung enthält keine Informationen über:
- Einnahmequellen
- Preismodelle
- Monetarisierungsstrategie
- Kundenakquise-Methoden
- Verkaufsprozess
nicht belegt: Es gibt keine Hinweise auf ein Geschäftsmodell oder eine Preisstruktur.
Technische & Auslieferungs-Signale
Der Autor stellt fest:
- Entwickelt mit: codex, gpt-5.6, next.js, node.js, openai-api, react, typescript, zod
- Verwendet strukturierte Ausgaben von OpenAI-Modellen
- Implementiert fail-closed-Verhalten
- Unterstützt manuelle Prüfung über signierte Tokens
- Exportiert Prüfungen als Markdown-Berichte
- Keine Datenbank-Speicherung – der Zustand ist ausschließlich client-seitig
- Die Audits umfassen 506 automatisierte Tests in 26 Testdateien
Schlussfolgerung: Die technische Architektur deutet auf eine leichte, frontend-lastige Lösung hin, die um KI-APIs und strukturierte Datenvalidierung herum aufgebaut ist. Sie betont Korrektheit durch Tests und die explizite Handhabung von Unsicherheit.
Traction & Reifegrad-Signale
Die Beschreibung stellt fest:
- Entwickelt während der Build Week (ein Event im Hackathon-Stil)
- Keine zuvor bestehende Anwendung – dies wurde von Grund auf erstellt
- Enthält einen finalen Audit-Workflow mit dokumentierten Risiken
- Hat 506 automatisierte Tests, Linting und Produktionsbuild-Prüfungen
- Wurde beim OpenAI 2026 Hackathon auf Devpost eingereicht
nicht belegt: Es gibt keine Hinweise auf Einnahmen, Kunden, Nutzerakzeptanz oder Marktdurchdringung über die eigene Darstellung des Autors hinaus.
Wettbewerbskontext
Die Beschreibung erwähnt nicht:
- Konkurrenten
- Marktpositionierung im Vergleich zu anderen
- Abgrenzung von ähnlichen Tools
- Branchentrends oder Lücken, die geschlossen werden
nicht belegt: Es wird keine Wettbewerbslandschaft beschrieben.
Offene Fragen & Risiken
Wichtige Risiken, die in der eigenen Darstellung des Autors identifiziert wurden:
- Modellinkonsistenz: Verschiedene Modelle können trotz bestandenem Schema-Check widersprüchliche Ergebnisse liefern
- Das fail-closed-Verhalten ist beabsichtigt, könnte aber als Einschränkung der Nutzererfahrung wahrgenommen werden
- Die externe Verifizierung ist bewusst deaktiviert – dies könnte die zukünftige Skalierbarkeit oder Nützlichkeit einschränken
- Keine persistente Speicherung – die Abhängigkeit vom client-seitigen Export begrenzt die langfristige Nutzbarkeit
Schlussfolgerung: Die Designentscheidungen des Tools spiegeln einen starken Fokus auf Korrektheit statt Bequemlichkeit wider, was Nutzer, die schnellere oder flexiblere Workflows suchen, möglicherweise abschreckt.
Fragen, die die Beschreibung offenlässt
- Gegen wie viele verschiedene OpenAI-Modelle haben Sie dies getestet? Was waren die Unterschiede in der Ausgabe?
- Können Sie uns erklären, wie der manuelle Prüfungsprozess in der Praxis funktioniert – wie sieht es für einen Prüfer aus, einen ungelösten Punkt zu klären?
- Haben Sie die Wirksamkeit Ihres vierschichtigen Systems mit echten Nutzern oder Teams validiert?
- Wie planen Sie, über den aktuellen Build Week-Prototypen hinaus zu skalieren, insbesondere im Hinblick auf Persistenz und externe Verifizierung?
- Welche konkreten Anwendungsfälle sind für dieses Tool am wertvollsten – und wie haben diese seine Gestaltung beeinflusst?
Gesamtbewertung
Die Autorin gibt an, dass Judgment Boundary ein selbst gemeldetes Projekt ist, das während eines Hackathons entwickelt wurde. Es gibt keine Belege für:
- Umsatz
- Kunden
- Product-market fit
- Traction oder Adoption
- Geschäftsmodell
- Finanzierung oder Bewertung
nicht belegt: In der bereitgestellten Beschreibung gibt es keine Grundlage für die Bewertung des Investitions- oder Partnerschaftspotenzials.
Umsetzen
Möchtest du etwas Ähnliches wie Judgment Boundary bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Judgment Boundary oder seinen Autoren verbunden.
User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde vontop-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.