

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #7.202 von 7.846 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
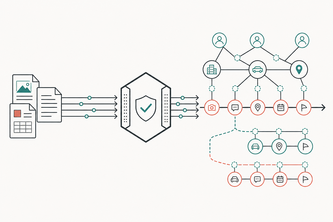
Die Beschreibung gibt an, dass Textual World Model ein Forschungsprototyp ist, der darauf abzielt, strukturierte Weltzustände aus langformatigen Texten zu rekonstruieren, mit einem Schwerpunkt auf Identitätsauflösung, Ereignisverfolgung und evidenzbasierter Unsicherheit. Es wird mit GPT-5.6 und Codex entwickelt und konzentriert sich auf begrenzte Erzählungen wie Romane oder Dokumente. Das System wird so beschrieben, dass es mehrere konkurrierende Hypothesen erzeugt, anstatt eine einzelne Zusammenfassung, und Mechanismen für Revision und Überprüfbarkeit enthält.
Wesentliche kommerzielle Due-Diligence-Einschätzung
Das Projekt befindet sich in einer frühen Forschungsphase, ohne Hinweise auf Produkt-Markt-Fit, Umsatz, Kunden oder Traction. Die Beschreibung weist keine Kommerzialisierungsstrategie oder Geschäftsmodell jenseits des Prototyps aus. Die wichtigste offene Frage ist, ob dieses Konzept in ein tragfähiges Produkt oder eine Dienstleistung skaliert werden kann, die reale Bedürfnisse jenseits akademischer oder Hackathon-Anwendungsfälle adressiert.
Was das Produkt tatsächlich ist
Die Beschreibung gibt an:
- Textual World Model rekonstruiert einen evidenzgestützten Weltzustand aus langformatigen Texten.
- Es konzentriert sich auf:
- Subjekte und ihre Aliase;
- Ereignisse und zeitliche Reihenfolge;
- Subjektrelative Zustände und Zustandsänderungen;
- Konkurrierende Interpretationen, wenn der Text mehrdeutig ist;
- Widersprüche und ungelöste Evidenz;
- Quellspannen, die jedes rekonstruierte Element stützen;
- Revisionen, die nach einer menschlichen Korrektur erzeugt werden.
- Anstatt eine einzige, sichere Zusammenfassung auszugeben, pflegt es eine Menge von Kandidaten-Welthypothesen.
- Der Prototyp konzentriert sich auf eine begrenzte, geschlossene Erzählung, wie einen Roman oder einen Dokumentenkorpus.
- Es verwendet GPT-5.6 und Codex in seinem Entwicklungstack.
Schlussfolgerung: Das System ist kein Allzweck-KI-Assistent oder Retrieval-Tool; es ist eine strukturierte Reasoning-Engine, die versucht, die in Texten beschriebene Welt zu modellieren, mit einem Schwerpunkt auf Nachverfolgbarkeit und Revision.
Positionierung & Claim-Entwicklung
Die Beschreibung gibt an:
- Das Produkt zielt darauf ab, eine schwierigere Frage als Retrieval oder Zusammenfassung zu beantworten: „Welche Welt beschreibt dieser Text, wie hat er seinen aktuellen Zustand erreicht und was ist noch unsicher?“
- Es positioniert sich als Rekonstruktions-Engine, nicht als Retrieval-System.
- Es steht im Kontrast zu:
- Retrieval-Systemen (die Dokumente zurückgeben),
- Knowledge Graphs (die davon ausgehen, dass Entitäten bekannt sind).
- Der Prototyp macht Produktverhalten und Audit-Trail sichtbar.
- Die tieferen Mechanismen (Identitätsauflösung, Ontologie-Promotion usw.) bleiben private Forschung.
Schlussfolgerung: Die Positionierung entwickelt sich von einem Forschungsprototyp hin zu einem strukturierten Reasoning-System für langformatige Texte, aber die Beschreibung weist keinen klaren kommerziellen oder Produkt-Roadmap jenseits der Hackathon-Einreichung aus.
Zielkunde & ICP
Die Beschreibung gibt an:
- Der Prototyp konzentriert sich auf begrenzte, geschlossene Erzählungen (z. B. Romane).
- Es ist so konzipiert, dass es mit Korpora von langformatigen Texten arbeitet.
- Es unterstützt menschliche Korrektur und Replay, was auf eine Rolle für Redakteure oder Analysten hindeutet, die Modelle validieren oder revidieren müssen.
Schlussfolgerung: Die Zielkunden könnten Content Creator, Forscher oder Analysten sein, die mit strukturierten Dokumenten oder Narrativen arbeiten. Es ist jedoch kein explizites ICP definiert, das über den Umfang des Prototyps hinausgeht.
Business Model & Preisbelege
Die Beschreibung lautet:
- Es werden keine Angaben zu Preisen, Einnahmen oder Geschäftsmodell gemacht.
- Es wird als Forschungs- und Engineering-Prototyp beschrieben, nicht als kommerzielles Produkt.
- Das System wird mit GPT-5.6 und Codex erstellt; es gibt keine Erwähnung von Lizenzierung oder API-Zugang.
Schlussfolgerung: Es gibt keine Hinweise auf ein Geschäftsmodell, eine Preisstruktur oder eine Monetarisierungsstrategie über die bloße Existenz des Prototyps hinaus.
Technische & Auslieferungs-Signale
Die Beschreibung lautet:
- Das System verwendet:
- Codex mit GPT-5.6
- Python, Ruby, Lean 4, JSON Schema, Git-basierte Provenienz
- Es kombiniert:
- Strukturierte Modell-Ausgaben
- Deterministische Evidenzprüfungen
- Versionierte Quellenschnitte
- Replay-Quittungen
- Beweispflicht-Schicht
- Ausgewählte begrenzte Eigenschaften werden in Lean 4 für Kompilierung und mathematische Aussagen ausgedrückt.
- Der Prototyp umfasst:
- Adversarial Codex Review
- Gegenbeispiel- und Replay-Prüfungen
- Maschinengeprüfte lokale Eigenschaften
Schlussfolgerung: Das System basiert auf einer Hybridlösung aus generativer KI und formaler Verifikation, mit einem Schwerpunkt auf Nachverfolgbarkeit und Korrektheit. Der Liefermechanismus oder die Plattform für Endbenutzer wird jedoch nicht beschrieben.
Traction & Reifegrad-Signale
Die Beschreibung lautet:
- Dies ist ein Build Week Prototyp, der beim OpenAI 2026 Hackathon eingereicht wurde.
- Es wird als Forschungsprojekt beschrieben, nicht als Produkt in Nutzung.
- Es werden keine Kundendaten, Nutzungsmetriken oder Hinweise auf Adoption bereitgestellt.
Schlussfolgerung: Es gibt keine Traction- oder Reifesignale über eine Hackathon-Einreichung hinaus. Das System wurde nicht in realen Bedingungen deployed oder getestet.
Wettbewerbskontext
Die Beschreibung lautet:
- Es steht im Kontrast zu:
- Retrieval-Systemen (z. B. RAG)
- Knowledge Graphs (die davon ausgehen, dass Entitäten bekannt sind)
- Es wird nicht als konkurrierend mit bestehenden Tools wie Notion, Obsidian oder unternehmensweiten Knowledge Bases beschrieben.
- Der Prototyp konzentriert sich auf strukturiertes Reasoning, nicht auf Allzweck-Tools.
Schlussfolgerung: Der Wettbewerbskontext ist unklar. Es könnte in einer Nische zwischen Retrieval- und strukturierten Knowledge-Systemen positioniert sein, aber es werden keine direkten Wettbewerber benannt oder beschrieben.
Offene Fragen & Risiken
Die Beschreibung lautet:
- Das System ist ein Forschungsprototyp, kein kommerzielles Produkt.
- Es gibt keine Hinweise auf:
- Einnahmen
- Kunden
- Product-Market-Fit
- Skalierbarkeit über den Prototyp hinaus
- Die tieferen Mechanismen bleiben private Forschung; es wird keine öffentliche API oder Tooling beschrieben.
- Es ist unklar, wie das System auf offene, unstrukturierte Dokumente oder reale Anwendungsfälle skaliert werden könnte.
Schlussfolgerung: Zu den wesentlichen Risiken gehören:
- Fehlende kommerzielle Tragfähigkeit
- Unklarer Weg zur Produktisierung
- Keine Hinweise auf Traction oder Nutzerfeedback
- Übermäßige Abhängigkeit von einem einzelnen Forschungs-Stack (GPT-5.6, Codex) ohne klaren Roadmap
Fragen, die die Beschreibung offenlässt
- Wie ist der beabsichtigte Übergang von diesem Prototyp zu einem kommerziellen Produkt?
- Wie behandelt das System offene oder unbeschränkte Texte (z. B. Meeting-Transkripte oder Unternehmensdokumente)?
- Gibt es Pläne für API-Zugang, Benutzeroberflächen oder Integrationen mit bestehenden Tools?
- Welche sind die zentralen Annahmen darüber, wie Nutzer mit konkurrierenden Hypothesen und Revisionen interagieren werden?
- Gibt es einen Plan, den Prototypen mit realen Anwendungsfällen jenseits des Hackathon-Umfelds zu validieren?
Gesamtbewertung
Die Beschreibung besagt:
- Dies ist ein Forschungsprototyp, der einem Hackathon vorgelegt wurde.
- Es gibt keine Hinweise auf:
- Umsatz
- Kunden
- Product-market fit
- Kommerzialisierungsstrategie
Schlussfolgerung: Das Projekt befindet sich in einer frühen Forschungsphase, ohne nachgewiesene kommerzielle Tragfähigkeit oder Traction. Es mag eine vielversprechende Idee sein, aber es gibt zu diesem Zeitpunkt keine Grundlage für eine Investition oder Partnerschaft.
Umsetzen
Möchtest du etwas Ähnliches wie Textual World Model bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Textual World Model oder seinen Autoren verbunden.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.