

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #5.302 von 7.846 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Company: MindDiff — ein selbstdeklariertes Bildungswerkzeug, das KI nutzt, um Missverständnisse von Studierenden in Programmieraufgaben durch Experimente statt Vermutungen zu diagnostizieren.
What Changed: Die Projektbeschreibung besagt, dass das Team ein System entwickelt hat, das falsche Überzeugungen hinter Code-Fehlern von Studierenden mit GPT-5.6 und Pyodide-sandboxierter Ausführung diagnostiziert, mit dem Ziel, über traditionelle Autograder oder KI-Tutoren hinauszugehen, die nur Fehler melden oder Korrekturen vorschlagen.
Single Most Important Open Question: Gibt es Belege für den realen Einsatz oder die Akzeptanz bei Studierenden oder Dozenten? Die Beschreibung enthält keine Daten zur Adoption, Nutzung oder zum Feedback von tatsächlichen Nutzern.
Was das Produkt tatsächlich ist
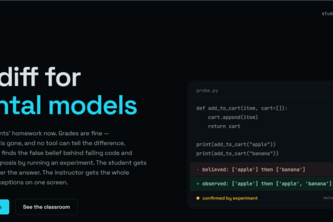
Die Beschreibung besagt, dass MindDiff ein Werkzeug zur Diagnose von Missverständnissen von Studierenden in Programmieraufgaben ist. Es liest fehlerhafte Python-Einsendungen, hypothesisiert die falsche Überzeugung hinter dem Fehler mit GPT-5.6 und entwirft diskriminierende Proben, um jede Hypothese durch Ausführung in einer Pyodide-Sandbox zu testen. Das System bestimmt anhand der Ausführungsergebnisse, ob das Missverständnis bestätigt, ausgeschlossen oder nicht überprüfbar ist.
Inference: Das Werkzeug scheint für den Bildungsbereich entwickelt worden zu sein, speziell für die Programmierausbildung, mit einem Schwerpunkt auf sokratischer Befragung und diagnostischem Feedback anstelle direkter Korrektur.
Positionierung & Claim-Entwicklung
Die Beschreibung besagt, dass MindDiff von dem Problem inspiriert wurde, dass KI-generierte Hausaufgaben zu einem "leise verschwindenden Verständnis" führen, da aktuelle Werkzeuge (Autograder und KI-Tutoren) nicht diagnostizieren, warum ein Student falsch liegt, sondern nur, dass er es tut. Das Werkzeug zielt darauf ab, seine Diagnose durch Ausführung statt durch Behauptung zu beweisen.
Inference: Die Positionierung ist, dass MindDiff ein diagnostisches Werkzeug für die Bildung ist, das über einfaches Feedback hinausgeht, um durch experimentelle Verifizierung ein tieferes Verständnis zu fördern.
Zielkunde & ICP
Die Beschreibung besagt, dass das Werkzeug für Studierende und Dozenten in der Programmierausbildung vorgesehen ist, insbesondere für diejenigen, die mit Python-Grundlagen arbeiten. Es erwähnt ein Dozenten-Dashboard mit Heatmaps und Clustering von Missverständnissen, was darauf hindeutet, dass es auf Pädagogen abzielt, die klassenweite Muster verstehen möchten.
Inference: Die primären Kundensegmente sind wahrscheinlich Studierende, die Programmieren lernen, und Dozenten, die Einführungs-Kursen in Programmierung unterrichten.
Business Model & Preisbelege
Die Beschreibung enthält keine Angaben zu Preisen oder einem Geschäftsmodell. Sie beschreibt nur die Funktionalität des Werkzeugs und wie es entwickelt wurde.
nicht belegt
Technische & Auslieferungs-Signale
Das Projekt wurde mit folgenden Komponenten erstellt:
- Stack: Next.js, TypeScript, Drizzle ORM über Turso/LibSQL, mit Zod validierte strukturierte Ausgaben aus dem OpenAI SDK, Pyodide für sandboxierte Python-Ausführung.
- Core Engine: In einer einzelnen Codex CLI-Sitzung auf GPT-5.6 Terra entwickelt.
- Deployment: Vercel/Turso.
Das System umfasst:
- Eine Pyodide-Sandbox zur Ausführung von Proben
- Strukturierte Ausgaben von GPT-5.6
- Rate Limiting und Eingabevalidierung
Inference: Das Werkzeug ist mit einem modernen Web-Stack gebaut und nutzt LLMs für das Reasoning, mit sandboxierter Ausführung, um serverseitige Code-Risiken zu vermeiden.
Traction & Reifegrad-Signale
Die Beschreibung besagt, dass das System end-to-end mit echten Einreichungen funktioniert, einschließlich Grenzfällen. Es erwähnt Belastungstests und die Behebung von Fehlern in Prompts und Kostenausnutzung, liefert jedoch keine Daten zu:
- Anzahl der Nutzer
- Nutzungshäufigkeit
- Feedback von Lehrkräften oder Studierenden
- Pilotprojekte im Unterricht oder Integration
nicht belegt
Wettbewerbskontext
Die Beschreibung erwähnt keine Wettbewerber oder Marktkontext, abgesehen vom allgemeinen Problem der automatischen Korrektur und KI-Tutoren.
nicht belegt
Offene Fragen & Risiken
- Keine Traction: Das Tool wird als Hackathon-Projekt beschrieben, ohne Belege für eine tatsächliche Verbreitung in der Praxis.
- Ungeprüfte Behauptungen: Das System behauptet, Diagnosen durch Ausführung zu belegen, aber die Beschreibung enthält keine Validierung oder Tests jenseits interner Belastungstests.
- Einzelner Entwickler: Die Teamgröße ist mit einem (Jugger Naut) angegeben, was die Skalierbarkeit oder die Geschwindigkeit der Produktentwicklung einschränken könnte.
- Keine Preisgestaltung oder Monetarisierungsstrategie: Es gibt keine Hinweise darauf, wie dies in einem echten Produkt monetarisiert werden würde.
Fragen, die die Beschreibung offenlässt
- Wurde das System mit tatsächlichen Studierenden und Dozenten getestet? Welches Feedback haben Sie erhalten?
- Wie planen Sie, über einen einzelnen Entwickler hinaus zu skalieren?
- Gibt es Pläne für Pilotprojekte im Unterricht oder Integrationen mit LMS-Plattformen?
- Wie lautet Ihr Weg zur Monetarisierung, falls vorhanden?
- Können Sie demonstrieren, wie das System Grenzfälle im realen Einsatz handhabt?
Gesamtbewertung
nicht belegt
Die Beschreibung ist eine selbstberichtete Darstellung eines Hackathon-Projekts. Sie enthält keine Belege für Umsatz, Kunden, Traction oder ein klares Geschäftsmodell. Die Funktionalität des Tools wird beschrieben, aber nicht durch externe Nutzung oder Feedback validiert.
Vertrauen: Niedrig. Die gesamte Analyse basiert auf der Darstellung eines Autors, ohne unabhängige Verifizierung oder Daten, die Behauptungen zu Wirkung oder Machbarkeit stützen.
Umsetzen
Möchtest du etwas Ähnliches wie MindDiff, git diff for mental models bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit MindDiff, git diff for mental models oder seinen Autoren verbunden.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.