

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #4.962 von 7.848 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.585 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 132 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
Wofür das Unternehmen offenbar steht
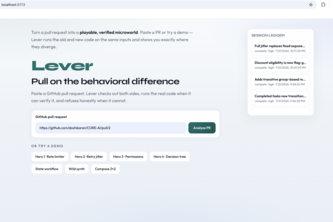
LEVER - Verified, Playable Code Diffs ist ein selbst gemeldetes Tool, das behauptet, echte Code-Änderungen in isolierten Sandboxes auszuführen, diese differential gegen frühere Versionen zu testen und visuelle Simulationen von Unterschieden bereitzustellen oder den Vorgang abzubrechen, wenn es das Verhalten nicht nachweisen kann. Es wurde im Rahmen einer OpenAI 2026 Hackathon-Einreichung entwickelt.
Was sich geändert hat
Der Autor gibt an, dass das Projekt aus der Frustration über von Sprachmodellen generierte Diffs entstand, die korrekt aussahen, aber keinen Verhaltensnachweis boten. Das Tool wird als eine Pipeline von Agenten beschrieben, die Code-Änderungen mithilfe der tatsächlichen Ausführung in E2B-Sandboxes verifiziert, mit Visualisierungen zum Verständnis von Divergenzen.
Wichtigste offene Frage
Gibt es Belege für tatsächliche Nutzung oder Traction über die Hackathon-Einreichung hinaus? Die Beschreibung enthält keine Daten zu Umsatz, Kunden, Adoption oder Product-Market-Fit – nur selbst gemeldete Behauptungen und technische Architektur.
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass LEVER:
- Einen GitHub PR übernimmt
- Diesen auf zwei exakte Commits auflöst
- Beide Versionen in isolierten Umgebungen auscheckt
- Byte-identische Harnesses für jede Version erstellt
- Echten Code in E2B-Sandboxes ausführt und differential Tests über 100+ Eingaben durchführt
- Wenn die Verifizierung bestanden wird, öffnet es eine spielbare Microworld-Simulation des Unterschieds
- Wenn die Verifizierung fehlschlägt, lehnt es ehrlich ab und nennt den Grund
- Stellt herunterladbare Harnesses und Stack Traces bereit
Das System wird als eine acht-Agenten-Pipeline mit phasengesteuerter Ausführung beschrieben, bei der jeder Agent eine Tatsache nachweisen muss, bevor der nächste beginnt.
Evidenz Selbst gemeldet vom Autor. Keine externe Validierung oder Demonstration über den Devpost-Beitrag hinaus.
Positionierung & Claim-Entwicklung
Die Beschreibung besagt, dass LEVER entwickelt wurde, um "cognitive debt" zu adressieren – die Lücke zwischen dem Lesen von Code und dem Verständnis seines Verhaltens, insbesondere wenn Diffs von Sprachmodellen ohne Verhaltensnachweis generiert werden.
Es positioniert sich als ein Tool, das Behauptungen über Diffs "falsifiable" (falsifizierbar) macht, anstatt nur plausibel. Es zielt darauf ab, narrative Beschreibungen von Änderungen durch messbare Ausführungsergebnisse zu ersetzen.
Schlussfolgerung Dies ist eine Neupositionierung von generischen Diff-Review-Tools hin zu einer Trust-Layer für die Verifizierung von Code-Änderungen, unter Verwendung von sandboxisierter Ausführung und visueller Simulation.
Zielkunde & ICP
Die Beschreibung gibt nicht an, wer der Zielkunde oder das ideale Kundenprofil (ICP) ist. Es impliziert die Nutzung durch Entwickler, die mit PRs arbeiten, aber es wird keine explizite Segmentierung oder Persona-Definition bereitgestellt.
Evidenz Nicht belegt.
Business Model & Preisbelege
Es gibt in der Beschreibung keine Belege für ein Geschäftsmodell oder eine Preisstruktur. Das Projekt wird als Hackathon-Einreichung beschrieben und enthält keinen Hinweis auf Monetarisierung, Lizenzierung oder Kundenakquisitionsstrategien.
Evidenz Nicht belegt.
Technische & Auslieferungs-Signale
Das System verwendet:
- E2B-Sandboxes für die Ausführung
- Eine acht-Agenten-Pipeline mit deterministischen Phasen
- Statische Analysetools (tree-sitter)
- Python, TypeScript, React, FastAPI, Pydantic, pytest, Vitest usw.
- Visuelle Grammatiken zur Darstellung von Unterschieden (z. B. particle arenas, access matrices, state machines)
Es umfasst:
- Echte Code-Ausführung in sandboxisierten Umgebungen
- Byte-Identitätsprüfungen zwischen Versionen
- Confidence Scoring basierend auf differential Testing
- Adversarial Search zur Identifizierung von Divergenzpunkten
- Test-Suites mit 167 bestanden Tests
Evidenz Selbstberichtete Angaben. Keine externe Validierung oder Leistungsdaten vorhanden.
Traction & Reifegrad-Signale
Es gibt keine Hinweise auf Traction, Umsatz, Kunden oder Adoption über die Hackathon-Einreichung hinaus. Das Projekt wird als Prototyp für einen Wettbewerb beschrieben und weist keinerlei Anzeichen von Nutzung in der Praxis oder Product-Market-Fit auf.
Evidenz Nicht belegt.
Wettbewerbskontext
Die Beschreibung erwähnt keine Wettbewerber oder bestehenden Tools in diesem Bereich. Es wird impliziert, dass aktuelle Tools nur narrative Beschreibungen von Diffs anbieten, jedoch wird kein spezifischer Vergleich mit anderen Plattformen vorgenommen.
Evidenz Nicht belegt.
Offene Fragen & Risiken
- Keine Hinweise auf Traction: Das Projekt wird als Hackathon-Einreichung beschrieben, ohne Daten zur Nutzung oder Adoption.
- Unbewiesene kommerzielle Tragfähigkeit: Es sind kein Geschäftsmodell, keine Preise und keine Monetarisierungsstrategie erkennbar.
- Hohe technische Komplexität ohne Validierung in der Praxis: Obwohl die Architektur detailliert ist, gibt es keine Anzeichen dafür, dass sie in der Produktion getestet oder über einen Prototyp hinaus skaliert wurde.
- Nur selbstberichtete Angaben: Alle Beschreibungen stammen vom Autor und sind nicht verifiziert.
Schlussfolgerung Das Tool mag technisch beeindruckend sein, mangelt aber an kommerzieller Tragfähigkeit oder Marktrelevanz, solange keine weiteren Hinweise auf Traction oder Kundenfeedback vorliegen.
Fragen, die die Beschreibung offenlässt
- Welcher konkrete Anwendungsfall wird gelöst? Wer wird dafür bezahlen?
- Wie unterscheidet sich dies von bestehenden Tools wie den Diff-Viewern von GitHub oder LLM-basierten Code-Review-Tools?
- Haben Sie dies mit echten Teams oder in Produktionsumgebungen getestet?
- Gibt es einen Plan, weitere Sprachen neben Python, JS und TS zu unterstützen?
- Wie sieht der Weg zur Monetarisierung oder zum Product-Market-Fit aus?
- Wie werden Grenzfälle behandelt, in denen die Sandbox-Ausführung fehlschlägt oder nicht möglich ist?
Gesamtbewertung
Nicht belegt.
Die Beschreibung enthält nicht genügend Belege, um zu beurteilen, ob dieses Projekt eine tragfähige Investitions- oder Partnerschaftsmöglichkeit darstellt. Es wird als Hackathon-Prototyp beschrieben, ohne Daten zu Traction, Umsatz, Kunden oder Geschäftsmodell.
Die technische Architektur ist detailliert und ambitioniert, bleibt aber ohne externe Validierung oder kommerzielle Signale spekulativ.
Vertrauensgrad Niedrig — basiert vollständig auf selbstberichteten Angaben und einer nicht verifizierten Projektbeschreibung.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.