

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #3.766 von 7.845 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.584 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 283 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
 top-founders.comThis project's analysis was made with it
Check your idea against real competitors
Paste your competitors' URLs and get what to match, where to stand out and what to skip, with every claim linked to its source. Free, no credit card.
Trigger reports from Slack or MCP server.
Das Projekt auf Devpost anzeigen
Executive Summary
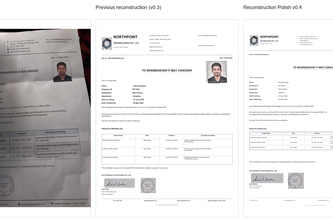
Was das Unternehmen zu sein scheint: Doclyt ist ein KI-gestütztes Werkzeug zur Dokumentenrestaurierung, das verzerrte Handyfotos in saubere, strukturierte digitale Dokumente umwandelt und dabei Layout, Tabellen, Logos, Signaturen und Stempel beibehält. Es wird als ein System beschrieben, das Dokumente als mehr als nur Text behandelt und sich auf visuelle Treue und strukturelle Genauigkeit konzentriert, anstatt auf die reine OCR-Extraktion.
Was sich geändert hat: Das Projekt wurde von einem Gründer, Arpan Mondal, beim OpenAI 2026 Hackathon eingereicht. Eine frühere Version oder Entwicklung wird nicht beschrieben; es handelt sich um einen eigenständigen, frühen Prototyp, der für den Kontext eines Hackathons entwickelt wurde.
Die wichtigste offene Frage: Gibt es Belege für Traction, Umsatz oder Kundenakzeptanz über die eigene Beschreibung des Autors hinaus?
Was das Produkt tatsächlich ist
Die Beschreibung besagt, dass Doclyt unvollkommene Handyfotos in saubere, strukturierte digitale Dokumente umwandelt und dabei Folgendes beibehält:
- Dokumentenlayout
- Tabellen
- Logos
- Signaturen
- Stempel
- Leseordnung
- Visuelle Hierarchie
Es wird als ein System beschrieben, das keine fehlenden Inhalte generiert, sondern stattdessen das bewahrt, was im Quellbild beobachtet wird. Der Autor betont, dass es als "treu" und nicht als "halluzinierend" konzipiert ist.
Das System nutzt klassische Computer Vision und KI-gestütztes Dokumentenverständnis, einschließlich:
- Bildvorverarbeitung (Perspektivkorrektur, Beleuchtungsnormierung, Rauschunterdrückung)
- OCR und Layoutanalyse
- Strukturelles Verständnis des Dokuments
- Erscheinungsform-bewusste Rekonstruktion
- Erhalt von Assets für Signaturen, Stempel und Logos
- Treuende Wiedergabe in ein sauberes digitales Dokument
Entwickelt mit FastAPI, Next.js, OpenCV, PaddleOCR, Python.
Schlussfolgerung: Das Produkt ist ein Dokumentenrestaurierungs-Engine, der sich auf visuelle Treue und Layouterhalt konzentriert. Es ist kein allgemeines OCR-Werkzeug, sondern ein spezialisiertes System zur Rekonstruktion von Dokumenten aus Bildern niedriger Qualität.
Positionierung & Claim-Entwicklung
Der Autor stellt fest, dass Doclyt kein OCR-Lösung im traditionellen Sinne ist, sondern vielmehr ein System, das ein Dokument als mehr als nur Text behandelt. Die Positionierung konzentriert sich auf:
- Treuende Bewahrung des ursprünglichen Erscheinungsbildes
- Visuelle Identität (Logos, Stempel, Typografie)
- Layout- und Strukturgenauigkeit
Es wird als ein System beschrieben, das entwickelt wurde, um "das Dokument treu zu rekonstruieren – nicht einfach nur OCR durchzuführen".
Schlussfolgerung: Das Produkt positioniert sich als Nischenlösung für Nutzer, die eine hochtreue Dokumentenrestaurierung benötigen und nicht nur Textextraktion. Dies impliziert einen Wandel von der traditionellen OCR hin zu visueller und struktureller Genauigkeit.
Zielkunde & ICP
Die Beschreibung nennt keine spezifischen Kunden oder Personas. Der Autor stellt jedoch fest:
- "Wir verbessern die visuelle Treue weiterhin, indem wir Typografie, Abstände, Tabellen und die Wiederherstellung von Assets verfeinern, während wir das System deterministisch und vertrauenswürdig halten."
Dies deutet auf eine potenzielle Zielgruppe hin, die aus Folgendem besteht:
- Unternehmen
- Regierungen
- Archive
- Einzelpersonen
Die Dokumente mit einer höheren Treue digitalisieren müssen als es traditionelle OCR-Arbeitsabläufe ermöglichen.
Schlussfolgerung: Die ICP sind wahrscheinlich Nutzer, die visuelle Genauigkeit der reinen Textextraktion vorziehen, wie z. B. Archivare, Juristen oder Regierungsbehörden, die mit offiziellen Dokumenten umgehen.
Business Model & Preisbelege
In der Beschreibung werden keine Hinweise auf Preise, Monetarisierungsstrategie oder Geschäftsmodell gegeben. Das Projekt wird als Hackathon-Einreichung präsentiert, ohne dass auf eine kommerzielle Machbarkeit oder Einnahmequellen hingewiesen wird.
nicht belegt
Technische & Auslieferungs-Signale
Das System wird mit folgenden Komponenten erstellt:
- FastAPI
- Next.js
- OpenCV
- PaddleOCR
- Python
Es verwendet eine Pipeline, die Bildvorverarbeitung, OCR und Layoutanalyse, strukturelles Verständnis, appearance-aware reconstruction und Asset Preservation umfasst.
Der Autor merkt an, dass die größte Herausforderung darin bestand, die Identität des Dokuments zu erhalten, anstatt den Text zu lesen, und dass er Zeit damit verbrachte, Verbesserung und Erhaltung in Einklang zu bringen.
Schlussfolgerung: Der technische Stack deutet auf eine Backend-API mit Frontend-UI hin, die Python-basierte Tools für Bildverarbeitung und OCR verwendet. Die Pipeline wird als deterministisch und treu zu den Eingabedaten beschrieben.
Traction & Reifegrad-Signale
Das Projekt wurde von einem Gründer, Arpan Mondal, beim OpenAI 2026 Hackathon eingereicht. Es werden keine Hinweise auf Traction, Kunden oder Adoption jenseits der eigenen Beschreibung des Autors gegeben.
nicht belegt
Wettbewerbskontext
In der Beschreibung wird kein Hinweis auf Wettbewerber oder Marktpositionierung gegeben. Der Autor verweist nicht auf bestehende Tools oder Plattformen, die ähnliche Funktionalitäten bieten.
nicht belegt
Offene Fragen & Risiken
- Frühstadium-Prototyp: Eingereicht bei einem Hackathon, ohne Hinweise auf frühere Versionen oder kommerzielle Entwicklung.
- Keine Traction oder Einnahmen: Keine Daten zu Nutzern, Kunden oder Monetarisierung.
- Einzelner Gründer: Die Teamgröße ist mit 1 angegeben.
- Unbewiesene Marktnachfrage: Keine Hinweise darauf, dass die Zielgruppe einen nachgewiesenen Bedarf an dieser spezifischen Lösung hat.
- Nur selbst gemeldet: Alle Aussagen sind unbestätigt und basieren auf der eigenen Beschreibung des Autors.
Schlussfolgerung: Dies scheint ein experimentelles oder exploratives Projekt ohne kommerzielle Validierung zu sein. Es weist keinerlei Signal für Product-Market-Fit oder Skalierbarkeit auf.
Fragen, die die Beschreibung offenlässt
- Welche spezifischen Anwendungsfälle haben Sie für dieses Tool identifiziert und wie unterscheiden sie sich von bestehenden OCR-Tools?
- Haben Sie das System an realen Dokumenten jenseits des Rahmens eines Hackathons getestet?
- Gibt es interne Daten oder Feedback, die zeigen, dass Nutzer visuelle Treue der reinen Textextraktion den Vorzug geben?
- Wie planen Sie, diese Lösung über einen Prototyp hinaus zu skalieren?
- Was ist Ihre Roadmap für die Monetarisierung, falls vorhanden?
Gesamtbewertung
Die Beschreibung stellt Doclyt als ein Projekt im Frühstadium eines Hackathons dar, ohne Hinweise auf Traction, Einnahmen oder Kundenadoption. Sie ist selbst gemeldet und unbestätigt.
nicht belegt
Konfidenz: Niedrig. Das Projekt wird als Prototyp beschrieben, der von einer Person für einen Hackathon erstellt wurde. Es gibt keine Hinweise auf kommerzielle Machbarkeit, Marktnachfrage oder Produktentwicklung über die ursprüngliche Einreichung hinaus.
Schlussfolgerung: Dies ist in diesem Stadium keine tragfähige Investitions- oder Partnerschaftsmöglichkeit. Es mag eine vielversprechende Idee mit Potenzial sein, weist aber keinerlei Hinweise auf Umsetzung oder Traction auf, die eine weitere Due Diligence rechtfertigen würden.
Umsetzen
Möchtest du etwas Ähnliches wie Doclyt: AI Document Restoration bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Doclyt: AI Document Restoration oder seinen Autoren verbunden.
User Stories BotVideo guides from your code
Get video guides for your users, generated from your code
Trigger narrated demos from Slack or MCP server to record PR changes or user guides.
Open-source maintainers review pull requests faster with a video of the feature working.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde vontop-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.