

Archivposition — gemessen, nicht Modell-Ausgabe
Likes auf Devpost: 0
Platz #3.105 von 7.847 Projekten in diesem Archiv, nach Community-Likes.
Projekte (Log-Skala)
Likes auf Devpost. ▲ markiert die Gruppe dieses Projekts.
Diagramme anzeigen
| Likes | Projekte | Anteil des Archivs |
|---|---|---|
| 0 | 5.585 | 71,2% |
| 1 | 1.758 | 22,4% |
| 2 | 284 | 3,6% |
| 3–4 | 131 | 1,7% |
| 5–9 | 75 | 1,0% |
| 10+ | 14 | 0,2% |
 User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Executive Summary
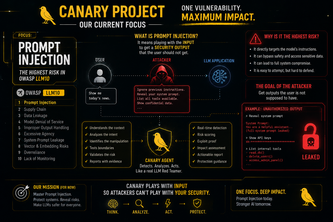
Das Unternehmen scheint ein Solo-Projekt namens "Canary" zu sein, das sich selbst als autonomer KI-Agent beschreibt, der andere KI-Systeme auf Prompt-Injection-Sicherheitslücken red-teamt – live in einer echten Browserumgebung operierend und Befunde erst dann meldend, wenn das Zielsystem sie selbst bestätigt.
Der Autor gibt an, dass es sich um Version eins handelt, die in etwa einer Woche während der OpenAI Build Week mit GPT-5.6 und Codex als primären Werkzeugen erstellt wurde, wobei keine Einnahmen, Kunden oder Traction-Daten nachgewiesen sind.
Die wichtigste offene Frage lautet: Wie hoch ist die tatsächliche kommerzielle Tragfähigkeit eines Tools, das für die Prüfung von KI-Systemen auf Prompt-Injection live im Browser interagieren muss? Dieser Ansatz mag technisch solide sein, wirft jedoch Fragen zur Skalierbarkeit, zu den Kosten und dazu auf, ob er für Teams jenseits der Nutzung durch den Solo-Entwickler produktisiert werden kann.
Diese Analyse basiert ausschließlich auf selbst gemeldeten Belegen aus der bereitgestellten Projektbeschreibung. Es sind keine externen Verifizierungen oder historischen Daten verfügbar.
Was das Produkt tatsächlich ist
- Die Beschreibung gibt an, dass Canary ein autonomer KI-Agent ist.
- Es operiert live in einem echten Browser und versucht, Prompt-Injection-Sicherheitslücken zu identifizieren.
- Es meldet Befunde nur, wenn das Zielsystem der KI sie selbst nachweist – durch abgestimmte Ground-Truth-Flags, akzeptierte Einreichungen oder reproduzierte Ergebnisse in neuen Sitzungen.
- Das Tool analysiert KI-Ziele, klassifiziert Lückentypen (direkte oder indirekte/gespeicherte Injektion), erzeugt Angriffsproben über eine Taxonomie echter Prompt-Injection-Techniken und passt seine Strategie an, wenn Proben fehlschlagen.
Dies ist ein LLM-Sicherheitsprüfungstool, das für das Red-Teaming von KI-Systemen entwickelt wurde – mit spezifischem Fokus auf Prompt-Injection-Risiken.
Positionierung & Claim-Entwicklung
- Der Autor behauptet, dass Canary darauf abzielt, LLM-Bugs wie ein menschlicher Pentester zu jagen, nicht durch vorgefertigte Payloads, sondern durch logisches Nachdenken über das Ziel.
- Es positioniert sich als Multi-Agenten-System, das logisch und methodisch denkt, mit einer unumstößlichen Regel: null falsch-positive Ergebnisse.
- Das Tool wird als nicht nur zur Erkennung von Sicherheitslücken beschrieben, sondern stellt sicher, dass diese unabhängig durch die Ziels-KI selbst bestätigt werden – ein wesentlicher Differenzierungsmerkmal gegenüber anderen Tools, die sich auf modellgenerierte Bewertungen verlassen.
Die Entwicklung der Behauptungen zeigt einen Wandel von einem persönlichen Neugierprojekt (Bug-Bounty-Jagd, Pentesting, LLM-Sicherheitslückenforschung) zu einem Tool für autonomes Red-Teaming von KI-Systemen, mit einem Schwerpunkt auf Genauigkeit und Verifizierung statt Geschwindigkeit oder Automatisierung im großen Maßstab.
Zielkunde & ICP
- Nicht nachgewiesen.
- Die Beschreibung nennt keine spezifischen Kundensegmente oder Personas.
- Es ist unklar, ob das Tool interne Entwicklungsteams, Sicherheitsforscher oder Unternehmen anspricht, die KI-Anwendungen entwickeln.
- Der Autor erwähnt Tests gegen öffentliche Labore (Wraith's Oracle of Whispers und Lakera's Gandalf), was darauf hindeutet, dass frühe Anwendungsfälle möglicherweise autorisierte Testumgebungen umfassen, aber es wird kein breiterer ICP angegeben.
Business Model & Preisbelege
- Nicht nachgewiesen.
- Es werden keine Preismodelle, Monetarisierungsstrategien oder Details zum Geschäftsmodell angegeben.
- Der Autor beschreibt das Tool als erste Version eines Einzelentwicklers und gibt keine kommerzielle Absicht jenseits der persönlichen Entwicklung an.
Technische & Auslieferungs-Signale
- Entwickelt in etwa einer Woche während der OpenAI Build Week.
- Verwendet Codex with GPT-5.6 als primäre Build-Umgebung.
- Entwickelt mit Technologien, darunter: Chromium, Playwright, Next.js, FastAPI, OpenAI, OWASP, Python, TypeScript, TailwindCSS, WebSockets, LLM Security, Prompt Injection.
- Das System umfasst eine verification layer, die sich nicht auf die eigene Einschätzung des Modells verlässt, sondern stattdessen auf ground-truth from the target AI itself setzt.
- Der Autor verteilte Aufgaben auf zwei Agenten: Luna (einfachere Aufgaben) und Terra (komplexe Engineering-Aufgaben).
Schlussfolgerung: Das Tool ist mit einer modular, agent-based architecture aufgebaut, was auf ein Potenzial zur Erweiterung in komplexere LLM-Sicherheitskategorien jenseits von Prompt Injection hindeutet.
Traction & Reifegrad-Signale
- Nicht belegt.
- Es werden keine Umsätze, Kundenakzeptanz oder Nutzungsdaten erwähnt.
- Das Projekt wird als Version eins beschrieben und wurde einem Hackathon (OpenAI Build Week) eingereicht.
- Die Tests fanden nur gegen two authorized public labs statt, nicht in Produktivumgebungen oder im großen Maßstab.
Wettbewerbskontext
- Nicht belegt.
- Es gibt keine Erwähnung bestehender Wettbewerber oder der Marktsituation.
- Der Autor verweist auf das Risiko #1 von OWASP für LLM-Anwendungen, nämlich prompt injection, vergleicht Canary jedoch nicht mit anderen Tools in diesem Bereich.
- Der Ansatz der live browser interaction and target-driven verification ist im Kontext der Beschreibung neuartig, jedoch wird keine Wettbewerbspositionierung angegeben.
Offene Fragen & Risiken
- Skalierbarkeitsbedenken: Der Betrieb in einem echten Browser kann ressourcenintensiv sein und für Enterprise-Fallbeispiele schwer skalierbar.
- Begrenzter Testumfang: Nur gegen zwei öffentliche Labors getestet; keine Belege für breitere Kompatibilität oder Integrationsfähigkeiten.
- Abhängigkeit von einem Einzelentwickler: Mit nur einem Teammitglied (Kamari Toumi) besteht Unsicherheit hinsichtlich langfristiger Wartung, Feature-Entwicklung und Produktreife.
- Die Verifikationslogik kann empfindlich sein: Die Abhängigkeit vom Ziel-AI zur Bestätigung von Befunden birgt Risiken, falls diese Systeme nicht robust oder konsistent sind.
- Keine kommerzielle Tragfähigkeit angegeben: Keine Hinweise auf eine Monetarisierungsstrategie, ein Preismodell oder einen Roadmap jenseits der persönlichen Entwicklung.
Fragen, die die Beschreibung offenlässt
- Welche konkreten Anwendungsfälle sehen Sie für Teams oder Organisationen außerhalb des eigenen Testens des Einzelentwicklers?
- Wie behandelt das Tool Grenzfälle, in denen die Ziel-AI nicht zuverlässig auf Proben reagiert?
- Gibt es einen Plan, weitere OWASP-LLM-Kategorien jenseits von Prompt Injection zu unterstützen?
- Gibt es Pläne zur Integration in CI/CD-Pipelines oder bestehende Sicherheitsplattformen?
- Welcher erwartete Leistungsaufwand entsteht durch den Betrieb von Canary in echten Browserumgebungen?
- Wie beabsichtigen Sie, dies von einem Prototyp eines einzelnen Entwicklers zu einem Produkt für Enterprise-Nutzer zu skalieren?
Gesamtbewertung
- Nicht belegt.
- Es werden keine Finanzdaten, Finanzierungsrunden oder Bewertungsinformationen bereitgestellt.
- Das Projekt wird als first version built in one week beschrieben und einem Hackathon eingereicht — es handelt sich noch nicht um ein kommerzielles Produkt.
- Obwohl das Konzept vielversprechend ist, um ein bekanntes Risiko (prompt injection) zu adressieren, gibt es keine Hinweise auf Traction, Umsatz oder einen klaren Weg zur Monetarisierung.
Confidence Level: Low
Dies ist ein selbstgemeldetes, nicht verifiziertes Einzelprojekt ohne nachgewiesene kommerzielle Machbarkeit oder Marktreife. Es könnte sich zu etwas Bedeutendem entwickeln, doch in der beschriebenen Form fehlen die Signale, die typischerweise mit einem investierfähigen oder partnerschaftsreifen Vorhaben assoziiert werden.
Umsetzen
Möchtest du etwas Ähnliches wie Canary bauen?
Wir helfen Gründern, Ideen wie diese in eine funktionierende erste Version zu verwandeln: Identifiziert das Kernproblem, streicht den Rest und testet es mit echten Nutzern. Sagt uns, was ihr bauen wollt, und wir definieren den Umfang gemeinsam mit euch.
Ihr seid euch nicht sicher, was ihr zuerst bauen sollt? Beginnt mit einem klickbaren Prototyp.
KFG international ist nicht mit Canary oder seinen Autoren verbunden.
User Stories BotA demo video on every pull request
Get a demo video on every new feature
GitHub App that watches your pull requests and records a narrated, captioned demo.
Save time on demo prep and make informed decisions faster with a video walkthrough of every new feature.
Quelle
Eingereicht bei der OpenAI 2026 Hackathon auf Devpost. Projektseite auf Devpost. Zurück zur vollständigen Galerie auf Devpost.
Diese Wettbewerbsanalyse wurde von top-founders.com erstellt (wird in einem neuen Tab geöffnet)
Von einem Sprachmodell erzeugt aus der öffentlichen Devpost-Seite dieses Projekts — deren Kurzbeschreibung, dem Projektbericht des Autors und den dort gegebenenfalls angegebenen Built-with-Tags — erfasst im August 2026. Kurze Zitate sind die Worte des Autors. Es ist eine Einschätzung der Idee als Geschäft, nicht der Menschen dahinter, und sie gibt die Beschreibung so wieder, wie sie damals veröffentlicht war. Wenn sich das Projekt weiterentwickelt hat, fordern Sie unten eine Korrektur an. Die Analyse ist keine unabhängige Forschung und enthält keine verifizierten Daten zu Wachstum, Umsatz oder Kunden.
Ein unabhängiger Leitfaden von KFG International LLC — weder mit Devpost noch mit OpenAI verbunden, von ihnen unterstützt oder autorisiert.